
Open-source of commerciële AI voor je bedrijf: wat past wanneer? (2026)
Open-weight of commerciële API? Beslistabel met twaalf situaties, rekenvoorbeeld voor 20 miljoen tokens langs drie routes en de AVG-kant, sept. 2026.
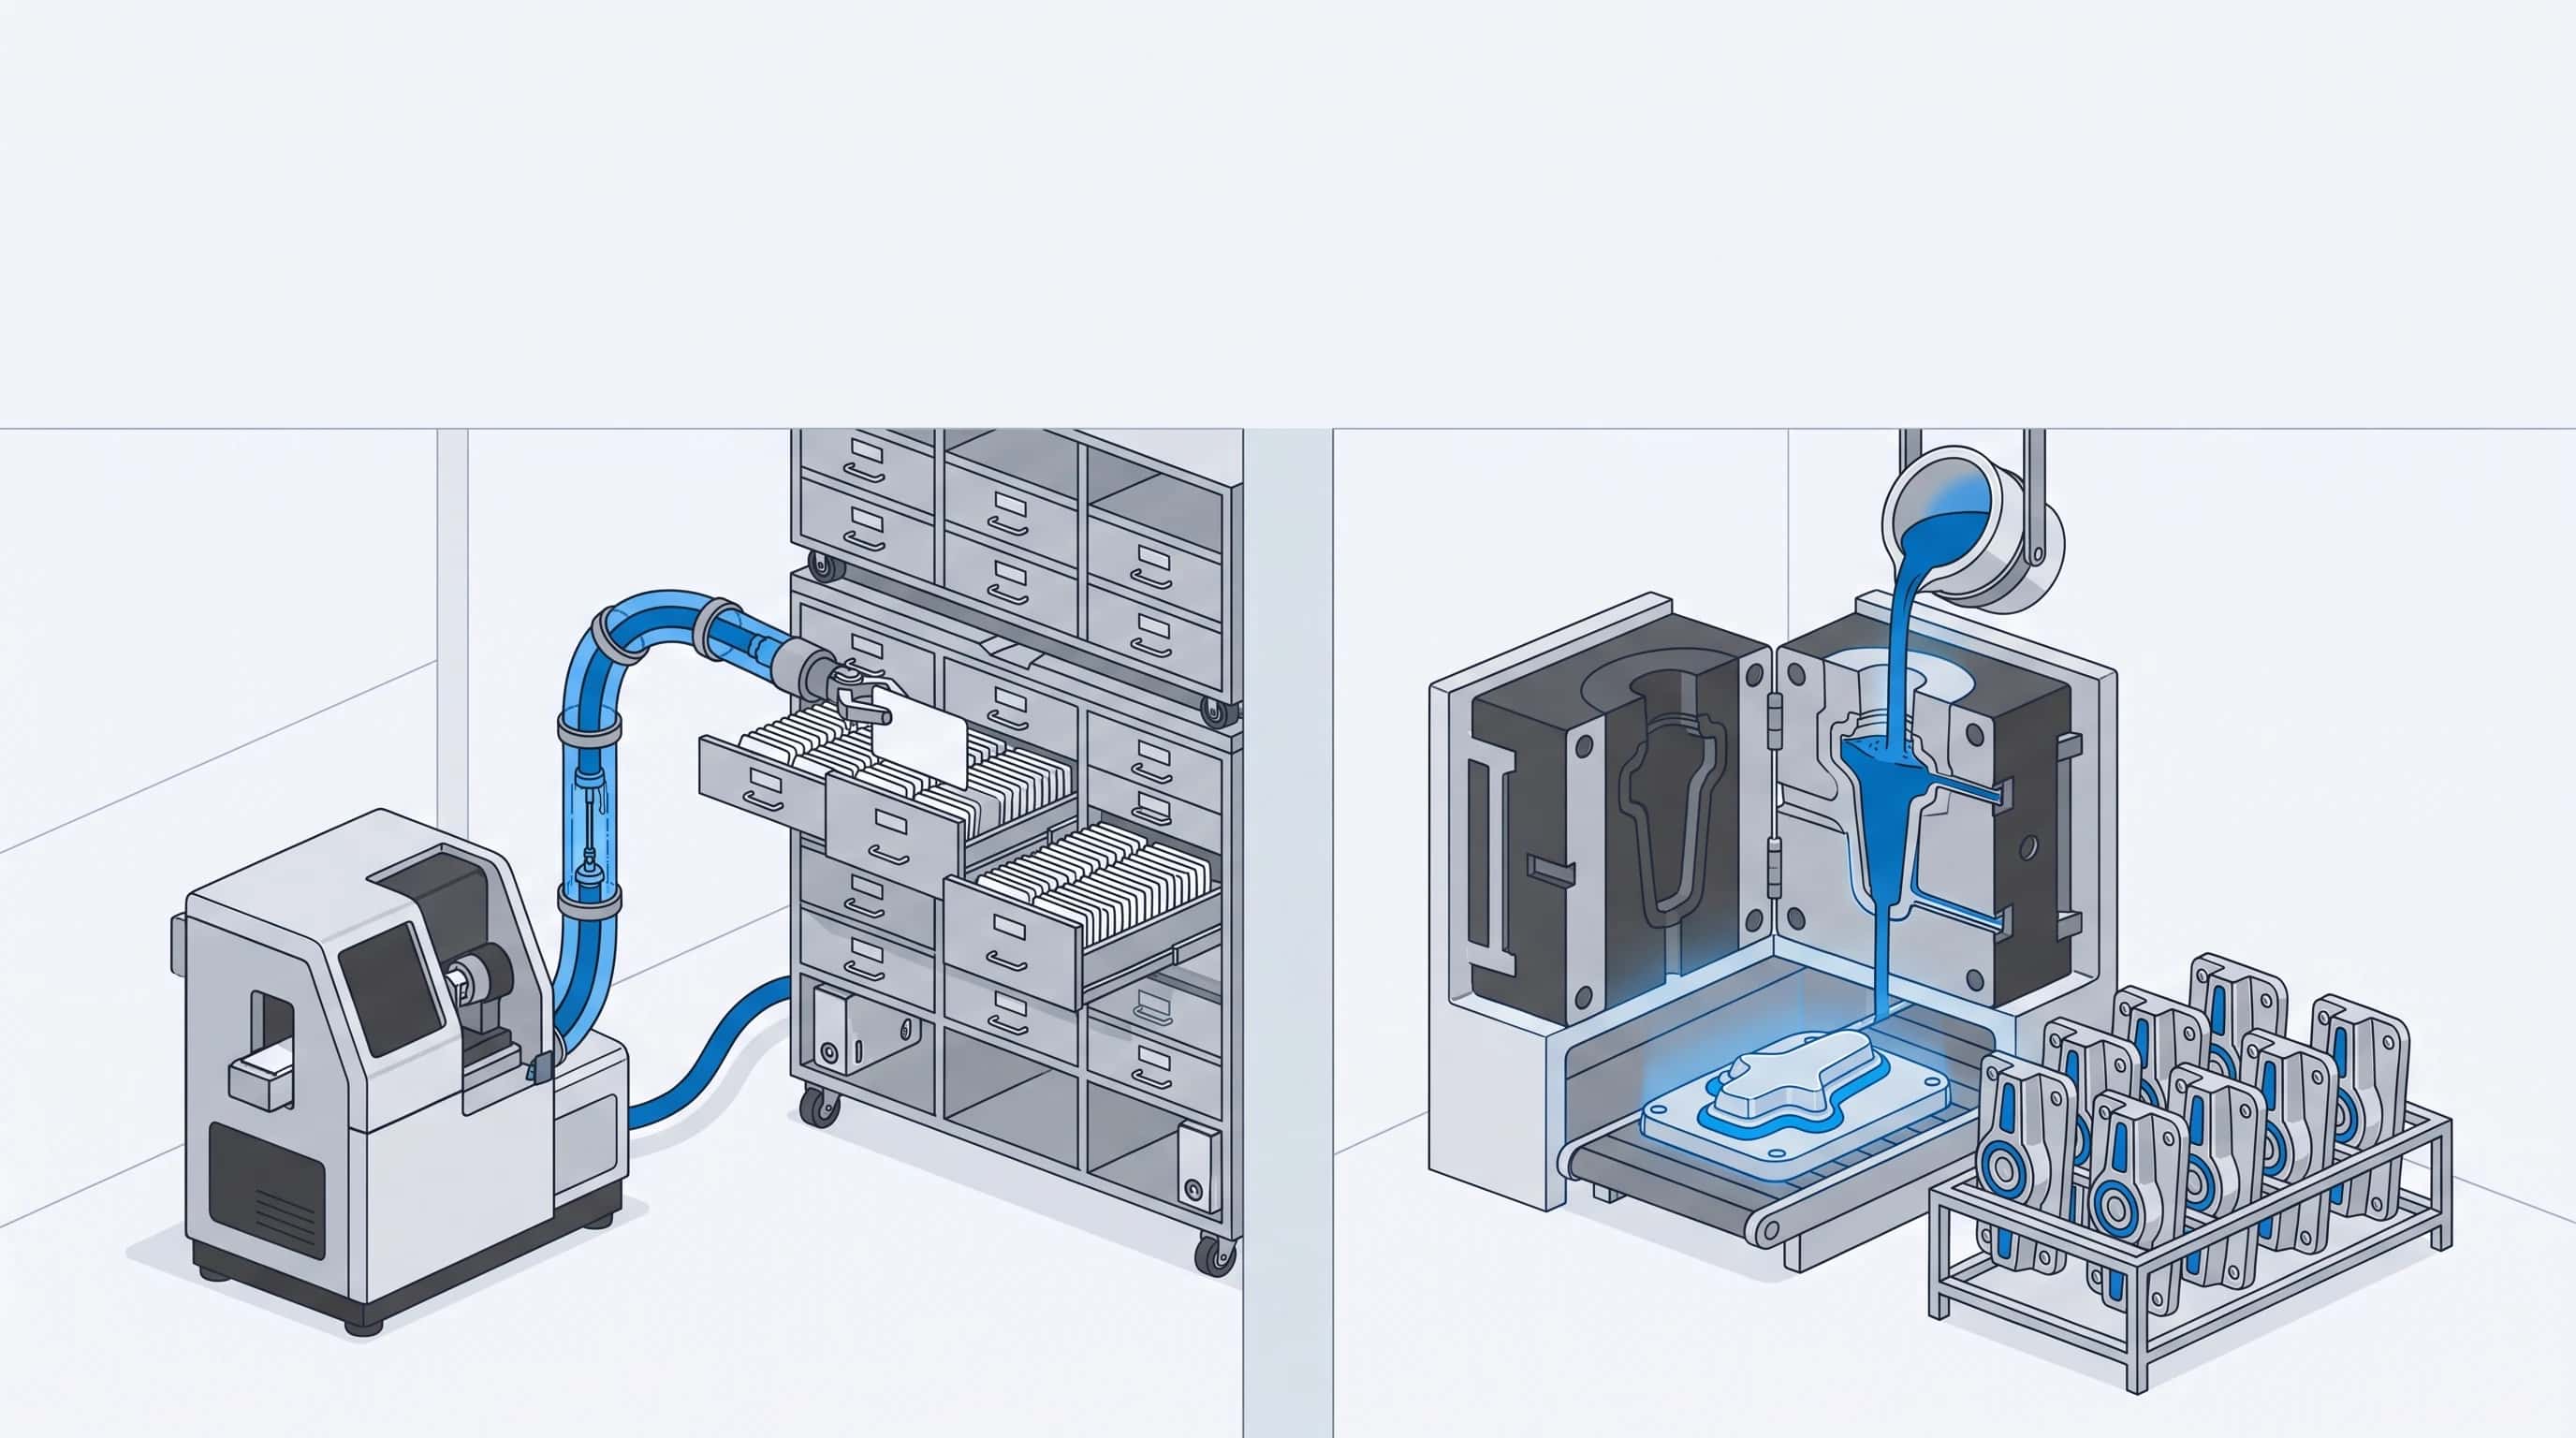
Open-weight AI (Llama 4, Mistral, Qwen, gpt-oss, DeepSeek)
Commerciële API (Claude, GPT, Gemini)

Het redactieteam van CleverTech AI combineert expertise in AI, procesautomatisering en digitale transformatie. Alle content wordt opgesteld met behulp van AI-tools en zorgvuldig gecontroleerd op juistheid, actualiteit en praktische toepasbaarheid door tech-leads met ervaring in AI, procesautomatisering en IT-consulting.
Bijgewerkt op
Kort antwoord
Kies een commerciële API (Claude, GPT, Gemini) als je de hoogste redeneerkwaliteit, agents en tooling nodig hebt en niemand in huis hebt die een GPU-stack beheert; dat is voor de meeste MKB-bedrijven het startpunt. Kies open-weight (Llama 4, Mistral, Qwen, gpt-oss, DeepSeek) als geen enkele externe partij je data mag zien, als je het model wilt finetunen en bezitten, als je offline moet draaien of als je een model in een eigen product wilt inbakken zonder licentie van een aanbieder. Kosten zijn bij MKB-volumes zelden de reden: 20 miljoen tokens per maand kosten omgerekend €69,81 bij Claude Sonnet 5 en €5,25 via gpt-oss-120B op een Franse API, tegenover €1.940 huur voor één H100 in Gravelines. De hybride vorm, commercieel voor de moeilijke stappen en open-weight waar data of licentie het afdwingt, is voor de meeste bedrijven de logische eindstand.
Waarom deze vergelijking?
Twintig miljoen tokens per maand kosten op 18 september 2026 omgerekend €69,81 bij Claude Sonnet 5, €5,25 bij gpt-oss-120B via een Franse API en €1.940 aan huur voor één H100 bij OVHcloud in Gravelines. Wie open-weight kiest om geld te besparen, kiest bij die volumes dus verkeerd.
De echte vraag is een andere: wat mag er met je data, wie moet het model beheren, hoe goed moet het redeneren en wil je het resultaat bezitten? Deze pagina beantwoordt die vraag met een beslistabel van twaalf situaties, een rekenvoorbeeld langs drie routes en de juridische kant.
Wat hier bewust niet staat: de modellenlijst met GPU-klasse en maandprijs per model, die vind je op de kostenpagina open-source AI-modellen zakelijk draaien, en de onderlinge keuze tussen Anthropic, OpenAI en Google, die hoort bij Claude tegenover ChatGPT.
Voor de eerlijkheid: ons eigen uitgangspunt bij nieuwe toepassingen is Claude. Toch adviseren we in vijf van de twaalf situaties hieronder een open model, en die vijf komen uit onze eigen projecten.
Zoek je een andere vraag uit dit cluster, van tokenprijzen tot verwerkersovereenkomsten, begin dan bij de index AI-modellen vergelijken.
Wat kies je?
Open-weight AI (Llama 4, Mistral, Qwen, gpt-oss, DeepSeek)
Modellen waarvan je de gewichten downloadt en zelf draait: op een eigen of gehuurde GPU, of via een Europese aanbieder die ze per token host. Jij kiest de locatie, de versie en de licentievoorwaarden; jij draagt ook het beheer.
- De enige route waarbij geen externe verwerker de tekst ziet: op een eigen of gehuurde GPU verlaat geen token je omgeving
- Apache 2.0 (Mistral Large 3, Small 4, Qwen 3.8, gpt-oss) en MIT (DeepSeek V4) geven commerciële vrijheid zonder toestemming van de maker (Mistral, 2026; Qwen, 2026; OpenAI, 2025)
- Een finetune is van jou: het resultaat draait op elke cloud of on-premises en vervalt niet als de aanbieder een model uitfaseert
- Offline inzetbaar: gpt-oss-20B past volgens de modelkaart in 16 GB geheugen, dus op één L4 van 24 GB, ook op een locatie zonder internet (OpenAI, 2025)
- Via een Europese API zonder eigen beheer: gpt-oss-120B kost bij Scaleway in Parijs €0,15 in en €0,60 uit per miljoen tokens (Scaleway, 2026)
- Een fallback die niet van één Amerikaanse aanbieder afhangt: toen Fable 5 in juni 2026 door exportcontrole stil lag, draaide een open-weight route gewoon door (Anthropic, 2026)
- Op complexe redeneertaken, codegeneratie en meerstaps-agents ligt de top bij Fable 5.1 en Opus 5.5 van Anthropic en Astra van OpenAI, niet bij de open modellen
- Zelf hosten betekent zelf beheren: inferentie-stack, drivers, monitoring, modelversies en incidenten zijn van jou, ook om drie uur ’s nachts
- Eén gehuurde H100 kost €1.940 per maand, één L40S €1.008, ongeacht of je er tokens doorheen stuurt (OVHcloud, 2026)
- Geen leverancier die een verwerkersovereenkomst, support en een uptime-belofte tekent; bij zelf hosten ben jij dat allemaal
- De Llama 4-licentie is geen open-source in de OSI-zin: boven 700 miljoen maandelijkse gebruikers heb je toestemming van Meta nodig en de naamsvermelding is verplicht (Meta, 2026)
- Agent-tooling zoals MCP-koppelingen, Claude Code of de Responses API moet je zelf nabouwen of missen
Commerciële API (Claude, GPT, Gemini)
Gesloten modellen die je per token of per seat afneemt bij Anthropic, OpenAI of Google, rechtstreeks of via Azure, AWS Bedrock en Google Vertex AI. De aanbieder beheert, verbetert en ondersteunt; jij betaalt per gebruik en tekent zijn voorwaarden.
- De hoogste redeneerkwaliteit van dit moment: Claude Fable 5.1 en GPT-6 Astra kosten beide $10 in en $50 uit per miljoen tokens; Claude Opus 5.5 zit volgens Anthropic bij het meeste werk op het niveau van Fable 5.1 (Anthropic, 2026) en kost $4 in en $20 uit (Anthropic, 2026; OpenAI, 2026)
- Geen beheer: een API-sleutel en een SDK, de rest doet de aanbieder, inclusief nieuwe modelversies
- Goedkoop bij laag volume: Claude Sonnet 5 kost $2 in en $10 uit, Gemini 3.8 Flash tot en met 31 december 2026 $0,75 aan invoer en $3,75 aan uitvoer, vanaf 1 januari 2027 $1,50 en $7,50 (Google, 2026)
- Verwerkersovereenkomst, trainingsverbod en support zitten vanaf de zakelijke tier in het contract
- Een EU-route bestaat bij alle drie: Claude via Vertex AI of Bedrock, OpenAI via eu.api.openai.com (+10% voor modellen vanaf 5 maart 2026), Gemini via Vertex AI
- Agent-tooling is af: MCP, Claude Code, de Responses API en de agent-SDK’s van de aanbieders zelf
- Je data gaat naar een verwerker; bij een harde eis "geen enkele externe partij" valt deze route af
- Een finetune blijft bij de aanbieder en verhuist niet mee als je overstapt
- De aanbieder bepaalt prijs, versie en beschikbaarheid: Anthropic legde Fable 5 tussen 12 juni en 1 juli 2026 wereldwijd stil door Amerikaanse exportcontrole
- De topmodellen zijn duur bij volume: 20 miljoen tokens per maand op Fable 5.1 of Astra kosten omgerekend €349,04, vijf keer Sonnet 5; op Opus 5.5 €139,62
- Geen offline gebruik: elke aanroep vereist een verbinding met de aanbieder of zijn cloudpartner
- Beleidsregels van de aanbieder gelden ook voor jouw toepassing; wat het model weigert, weigert het
De harde vergelijking
| Kenmerk | Open-weight AI (Llama 4, Mistral, Qwen, gpt-oss, DeepSeek) | Commerciële API (Claude, GPT, Gemini) |
|---|---|---|
| Data verlaat je omgeving niet | Ja, op een eigen of gehuurde GPU | Nee; hooguit een EU-regio bij een verwerker |
| Data in de EU bij een verwerker | Scaleway (Parijs), OVHcloud (Gravelines), Mistral EU-endpoint | Vertex AI, Bedrock, Azure OpenAI, eu.api.openai.com |
| Redeneerkwaliteit aan de top | Onder de frontier | Fable 5.1, Opus 5.5, GPT-6 Astra |
| Topmodel per miljoen tokens (in / uit) | Mistral Medium 3.5 €1,50 / €7,50 (Scaleway) | Fable 5.1 en Astra $10 / $50; Opus 5.5 $4 / $20 |
| Werkpaard per miljoen tokens (in / uit) | gpt-oss-120B €0,15 / €0,60; Qwen 3.8-27B €0,60 / €3,30 | Sonnet 5 $2 / $10; Terra $2 / $12; Gemini 3.8 Flash $0,75 / $3,75 |
| 20 miljoen tokens per maand (rekenvoorbeeld) | €5,25 (gpt-oss-120B, API) of €1.940 (eigen H100) | €69,81 (Sonnet 5) tot €349,04 (Fable 5.1), omgerekend |
| Vaste maandkosten zonder gebruik | Eigen GPU: €1.008 tot €1.940 per kaart; API: geen | Geen |
| Licentie en doorverkoop | Apache 2.0 en MIT vrij; Llama 4 met 700 miljoen-drempel | Gebruiksvoorwaarden van de aanbieder |
| Finetune in eigendom | Ja, draait overal | Nee, blijft bij de aanbieder |
| Offline of zonder internet | Ja, gpt-oss-20B (16 GB) op één L4 van 24 GB | |
| Beheer en beschikbaarheid | Jij, of de EU-host bij een gehoste API | De aanbieder |
| Verwerkersovereenkomst en support | Alleen via een gehoste API; zelf hosten: niemand | Vanaf de zakelijke tier |
| Agent-tooling (MCP, Claude Code, Responses API) | Zelf bouwen of via open frameworks | Meegeleverd |
| Afhankelijkheid van één aanbieder | Laag: gewichten staan bij jou | Hoog: prijs, versie en beschikbaarheid bij de aanbieder |
| AI Act artikel 2 lid 12 | Vrijstelling voor de verordening, behalve hoog-risico en artikel 5 en 50 | Geen vrijstelling; aanbieder is provider |
| Tijd tot eerste werkende versie | Dagen via een gehoste API; weken op een eigen GPU | Uren |
Wat is het verschil tussen open-weight en een commerciële API?
Bij een open-weight model krijg je het bestand met de getrainde parameters en mag je dat zelf draaien. Bij een commerciële API krijg je alleen antwoorden terug; het model zelf staat bij Anthropic, OpenAI of Google.
Dat ene verschil sleept vier andere mee. Wie het model draait, ziet de data; wie het draait, beheert het; wie het bezit, mag het finetunen en bewaren; en wie het niet bezit, is afhankelijk van wat de aanbieder ermee doet.
"Open source" is voor vrijwel al deze modellen te veel gezegd, want de trainingsdata blijft geheim. Voor de keuze op deze pagina maakt dat niet uit: het gaat om wat je met de gewichten mag, en dat regelt de licentie, niet de naam.
Tussen beide uitersten zit een derde vorm die de beslistabel apart behandelt: een open-weight model dat een Europese aanbieder per token voor je host. Je krijgt dan de licentievrijheid en de Europese locatie van open-weight, met het gemak en de verwerkersovereenkomst van een API.
De beslistabel: twaalf situaties, één antwoord per rij
Deze tabel is onze eigen samenvatting van de afwegingen die we bij klanten tegenkomen. Zoek de rij die op jouw situatie past; staan er meerdere rijen op jou van toepassing, dan wint de bovenste.
| Situatie | Kies | Waarom |
|---|---|---|
| Geen enkele externe partij mag de tekst zien | Open-weight op een eigen of gehuurde GPU | Alleen daar verlaat geen token je omgeving |
| De toepassing moet zonder internet werken | Open-weight, klein model | gpt-oss-20B past in 16 GB geheugen en dus op één L4 van 24 GB (€540 per maand bij OVHcloud) of op eigen hardware |
| Je bakt het model in een product dat je doorverkoopt | Open-weight onder Apache 2.0 of MIT | Geen prijslijst of beleid van een aanbieder in je productmarge |
| Je wilt finetunen en het resultaat bezitten | Open-weight | Een finetune bij een aanbieder verhuist niet mee |
| Honderden miljoenen tokens per maand aan eenvoudige taken | Open-weight via een EU-API, later eventueel eigen GPU | gpt-oss-120B kost €0,15 / €0,60 per miljoen; een H100 wordt pas boven ruim een half miljard tokens goedkoper dan Sonnet 5 |
| Complexe analyse, code of meerstaps-agents | Commerciële API | Fable 5.1, Opus 5.5 en Astra vormen de frontier |
| Niemand in huis die een inferentie-stack beheert | Commerciële API of gehoste open-weight API | Zelf hosten zonder beheerder is een risico, geen besparing |
| Je wilt een verwerkersovereenkomst, support en een uptime-belofte van één partij | Commerciële API of gehoste open-weight API | Bij zelf hosten teken je die alle drie zelf |
| Data moet in de EU blijven, verwerker is toegestaan | Beide | Scaleway en OVHcloud voor open-weight; Vertex AI, Bedrock, Azure en eu.api.openai.com voor commercieel |
| Je bouwt agents met MCP, Claude Code of de Responses API | Commerciële API | De tooling is er al; nabouwen kost meer dan het model scheelt |
| Modelbudget onder een paar honderd euro per maand | Commerciële API | 20 miljoen tokens kosten op Sonnet 5 omgerekend €69,81; een GPU kost €1.008 tot €1.940 zonder één token |
| Je wilt niet stilvallen als één Amerikaanse aanbieder stilvalt | Commercieel als hoofdroute, open-weight als fallback | Fable 5 lag in juni 2026 negentien dagen stil; een router met open-weight fallback ving dat op |
De rijen over data, offline, licentie en finetuning zijn hard: daar bestaat geen commercieel alternatief. De rijen over kwaliteit, beheer en tooling zijn zacht: daar kun je met geld en tijd de andere kant op.
Rekenvoorbeeld: 20 miljoen tokens per maand langs drie routes
Stel, een toepassing verwerkt per maand 15 miljoen tokens aan invoer en 5 miljoen aan uitvoer, een verhouding die past bij een assistent die documenten leest en korte antwoorden schrijft. Alles hieronder is een rekenvoorbeeld op lijstprijzen, afgelezen op 18 september 2026 (Claude Opus 5.5 en GPT-6 Luna op 22 september 2026, de dag dat ze uitkwamen), en geen offerte.
Dollarbedragen zijn naar euro omgerekend met de referentiekoers die de ECB voor 18 september 2026 publiceerde, 1,1460 (ECB, 2026); alle bedragen zijn exclusief btw.
| Route | Model | Prijs per miljoen tokens (in / uit) | Kosten per maand |
|---|---|---|---|
| Eigen GPU in de EU | gpt-oss-120B of Llama 4 Scout op 1× H100 (OVHcloud Gravelines) | Huur €1.940 per maand | €1.940 plus beheer |
| Eigen GPU in de EU | Qwen 3.8-27B op 1× L40S (OVHcloud Gravelines) | Huur €1.008 per maand | €1.008 plus beheer |
| Gehoste open-weight API in de EU | gpt-oss-120B (Scaleway, Parijs) | €0,15 / €0,60 | €5,25 |
| Gehoste open-weight API in de EU | Mistral Small 4 (Mistral, EU-endpoint +10%) | $0,15 / $0,60 | omgerekend €5,04 |
| Gehoste open-weight API in de EU | Mistral Large 3 (Mistral, EU-endpoint +10%) | $0,50 / $1,50 | omgerekend €14,40 |
| Gehoste open-weight API in de EU | Qwen 3.8-27B (Scaleway, Parijs) | €0,60 / €3,30 | €25,50 |
| Gehoste open-weight API in de EU | Mistral Medium 3.5 (Scaleway, Parijs) | €1,50 / €7,50 | €60,00 |
| Commerciële API | GPT-6 Luna | $0,10 / $0,50 | omgerekend €3,49 |
| Commerciële API | Gemini 3.8 Flash (promotie t/m 31-12-2026) | $0,75 / $3,75 | omgerekend €26,18; vanaf 2027 €52,36 |
| Commerciële API | Claude Sonnet 5 | $2 / $10 | omgerekend €69,81 |
| Commerciële API | GPT-5.6 Terra | $2 / $12 | omgerekend €78,53 |
| Commerciële API | Claude Opus 5.5 | $4 / $20 | omgerekend €139,62 |
| Commerciële API | Fable 5.1 (Claude) of Astra (GPT-6) | $10 / $50 | omgerekend €349,04 |
Bronnen per rij: OVHcloud prijzen, Scaleway Generative APIs, Mistral API-prijzen, OpenAI API-prijzen, Gemini API-prijzen en Claude API-prijzen, afgelezen op 18 september 2026; de rijen voor Opus 5.5 en GPT-6 Luna op 22 september 2026, omgerekend tegen dezelfde koers.
Drie conclusies volgen uit de tabel. De kleine modellen zijn bij dit volume de goedkoopste route, GPT-6 Luna via OpenAI en een gehoste open-weight API in de EU, met een verschil van ruim een factor tien tegenover Sonnet 5; een eigen H100 is de duurste, met een verschil van bijna een factor dertig de andere kant op.
Het omslagpunt van die H100 ligt bij dezelfde tokenmix boven 550 miljoen tokens per maand tegenover Sonnet 5 en boven 7 miljard tegenover gpt-oss-120B op Scaleway. Of één kaart die aantallen überhaupt haalt, hangt af van je contextlengte en piekbelasting; reken erop dat je eerder een tweede kaart huurt dan dat je het omslagpunt raakt.
De derde conclusie is de belangrijkste: bij 20 miljoen tokens per maand is het verschil tussen alle API-routes samen kleiner dan één uur beheer. Wie open-weight kiest, doet dat om de rijen uit de beslistabel, niet om deze tabel.
Wat het beheer kost als je het niet zelf doet, staat verderop bij onze prijsband; wat elk open model afzonderlijk per maand doet op een GPU, staat op de kostenpagina.
Wanneer open-weight de betere keuze is
Vijf situaties waarin wij zelf een open-weight model adviseren, ook al is Claude onze default.
Dataresidentie zonder verwerker. Sommige contracten en beroepsgeheimen sluiten elke externe partij uit, ook een Europese. Dan blijft alleen een GPU over die jij beheert, in je eigen serverruimte of gehuurd bij een Europese provider.
Licentiecontrole. Wie een model in een product inbakt en dat product verkoopt, wil geen prijslijst van een aanbieder in zijn marge. Apache 2.0 bij Mistral Large 3, Small 4, Qwen 3.8 en gpt-oss, en MIT bij DeepSeek V4, geven die vrijheid zonder toestemming vooraf (Mistral, 2026; DeepSeek, 2026).
Finetuning in eigendom. Een model dat je op eigen data traint, is bij open-weight een bestand dat je overal kunt draaien. Bij een aanbieder blijft die training een dienst die je huurt.
Offline. Een schip, een productielijn zonder buitenverbinding of een beveiligde ruimte kan geen API aanroepen. gpt-oss-20B past volgens zijn modelkaart in 16 GB geheugen (OpenAI, 2025); dat is onze afleiding naar één L4-kaart van 24 GB, en daar levert het bruikbare tekstverwerking.
Volume met eenvoudig werk. Classificeren, extraheren en samenvatten op honderden miljoenen tokens per maand kan Qwen 3.8-27B of gpt-oss-120B prima aan, tegen €0,15 tot €0,60 per miljoen invoertokens via een Franse API.
Welk model in welke van deze vijf situaties past, en op welke GPU, staat uitgewerkt op open-source AI-modellen zakelijk draaien. Voor de Europese maker in dit rijtje is er een aparte pagina over wat Mistral zakelijk kost.
Wanneer een commerciële API de betere keuze is
Vier situaties waarin we een open-weight model afraden, ook als de klant erom vraagt.
Frontier-kwaliteit. Voor complexe analyse, codegeneratie en agents die tien stappen achter elkaar goed moeten zetten, ligt de top bij de frontier-modellen Fable 5.1, Opus 5.5 en Astra. Een open model dat op een benchmark dichtbij komt, is in zulk werk merkbaar minder betrouwbaar, en die betrouwbaarheid is wat je betaalt.
Geen beheercapaciteit. Een gehuurde GPU zonder iemand die vLLM, drivers, monitoring en modelversies bijhoudt, is geen besparing maar een storing die nog moet gebeuren. Een API neemt dat werk weg; een gehoste open-weight API ook, dus die valt hier aan de goede kant.
Contract en support. Vanaf Claude Team, ChatGPT Business of een Vertex-project zit de verwerkersovereenkomst, het trainingsverbod en een supportkanaal in het contract. Bij zelf hosten ben jij verwerker, beheerder en helpdesk tegelijk.
Agents en tooling. MCP-koppelingen, Claude Code, de Responses API en de agent-SDK’s van de aanbieders bestaan al en worden onderhouden. Wie dat op een open model nabouwt, betaalt in ontwikkeltijd meer dan het model per token scheelt.
Welke van de drie commerciële aanbieders dan, en welk model binnen die lijn, staat op Claude tegenover ChatGPT en in ons overzicht van de zeven AI-modelfamilies.
De AVG en de AI Act in deze keuze
Onder de AVG is de vraag niet "open of gesloten" maar "wie is verwerker". Op een eigen GPU is er geen verwerker; bij Scaleway, OVHcloud, Vertex AI, Bedrock of eu.api.openai.com is de host dat, en tekent hij de verwerkersovereenkomst.
Een Europese host is daarbij geen garantie op een Europese keten. Vertex AI en Bedrock zijn Amerikaanse bedrijven met een EU-regio; Scaleway en OVHcloud zijn Europese bedrijven; welke route juridisch wat oplevert, staat op AI-modellen in de EU hosten.
De AI Act kent in artikel 2 lid 12 een vrijstelling voor AI-systemen die onder een vrije of open-source licentie zijn uitgebracht, tenzij ze als hoog-risicosysteem of onder artikel 5 of 50 in de handel komen (EU AI Act, artikel 2). Die vrijstelling helpt de aanbieder van het model, niet vanzelf jou.
Wie een open-weight model finetunt voor sollicitantenselectie, kredietbeoordeling of een andere bijlage III-toepassing, wordt zelf aanbieder van een hoog-risicosysteem met alle eisen van dien. Voor interne tekstverwerking of een documentassistent speelt dat niet, met open of gesloten model.
De bredere vraag of Europa met Mistral en GPT-NL een eigen AI-keten krijgt, hoort niet op deze pagina; die staat op digitale soevereiniteit en AI in Europa.
De hybride route en wat overstappen kost
De meeste bedrijven eindigen niet bij één kamp. De moeilijke stappen gaan naar een commercieel model, het bulkwerk naar een open model via een Europese API, en een eigen GPU komt er uitsluitend waar data-eisen dat opleggen.
Dat werkt alleen met een laag ertussen die per taak naar het juiste model stuurt. Zo’n router is bij ons standaard onderdeel van elke AI-toepassing, omdat hij ook de fallback regelt: valt de hoofdaanbieder weg, dan neemt de tweede route het over.
Overstappen achteraf is haalbaar, maar niet gratis. Prompts die op Claude goed werken, reageren op Llama of Qwen anders, tool-definities verschillen per aanbieder en een finetune bij een aanbieder moet je op het open model opnieuw doen.
Plan voor een overstap vier tot zes weken proefdraaien op je eigen taken voordat je productie omzet. Of je daarbij beter kunt finetunen of het model met je eigen documenten voedt, staat op RAG tegenover finetuning.
Waar wij staan: Claude-first, open-weight waar het moet
Ons uitgangspunt is Claude, met Opus 5 en Sonnet 5 als startpunt voor redeneer- en documentwerk, met Fable 5.1 waar de taak het vraagt. Dat is een kwaliteitskeuze die we per project toetsen, geen principe, en de vijf open-weight situaties hierboven komen uit onze eigen projecten.
Voor de software eromheen geldt dezelfde prijsband, welk model er ook in zit. AI-software op eigen data start bij €8.500 voor één ingebouwde AI-feature, RAG-zoeken vanaf €12.500 en een volledig AI-platform tot €75.000 of hoger; onderhoud daarna vanaf €750 per maand, modelkosten apart.
Kies je open-weight en wil je het beheer niet zelf dragen, dan is dat Managed AI: €500 (Basis), €1.000 (Standaard) of €1.500 tot €2.500 (Premium) per maand. Dat bedrag komt bovenop de GPU-huur uit het rekenvoorbeeld en is de post die een API-aanbieder in zijn tokenprijs verstopt.
Twijfel je welke rij van de beslistabel op jou past? Bel 085 016 0118 of stuur een bericht; dan zetten we jouw situatie in de tabel, met je eigen tokenaantallen en je eigen data-eisen.
Twijfel je welke past bij jouw situatie? We denken vrijblijvend mee — Open-weight AI (Llama 4, Mistral, Qwen, gpt-oss, DeepSeek) of Commerciële API (Claude, GPT, Gemini).
Wat kies je wanneer?
Het hangt af van je situatie
Open-weight wint waar geen commercieel alternatief bestaat: data die geen externe partij mag zien, offline gebruik, een finetune in eigendom en een licentie zonder aanbieder in je productmarge. Een commerciële API wint op redeneerkwaliteit, agent-tooling, contract en het ontbreken van beheer, en is bij MKB-volumes niet duurder dan een eigen GPU: 20 miljoen tokens per maand kosten omgerekend €69,81 op Claude Sonnet 5 tegenover €1.940 huur voor één H100. Een gehoste open-weight API in de EU zit ertussenin: Europese locatie en licentievrijheid zonder beheer, voor €5,25 per maand in hetzelfde rekenvoorbeeld.
Begin met een commerciële API als geen van de harde rijen uit de beslistabel op je van toepassing is; bij ons is dat Claude, met Sonnet 5 als werkpaard en Opus 5 of Fable 5.1 waar de taak het vraagt. Zet bulkwerk op een open model via Scaleway of OVHcloud zodra het volume in de honderden miljoenen tokens loopt, en huur pas een eigen GPU als de data of de licentie het afdwingt, met beheer erbij begroot. Bouw vanaf dag één een router tussen je toepassing en de modellen, zodat de tweede route de eerste kan vervangen.
Opgesteld met AI-ondersteuning, geredigeerd en inhoudelijk verantwoord door het Redactieteam CleverTech AI.
Meer lezen
- DienstAI Software Ontwikkeling
- DienstManaged AI
- GidsAI-modellen vergelijken: welk model, wat het kost en wat mag
- ArtikelOpen-source AI-modellen zakelijk draaien: welke, waar en wat kost het (2026)?
- ArtikelWat kost Mistral zakelijk in 2026 en welke modellen zijn er (Vibe, API)?
- ArtikelWelke AI-modellen kun je in de EU laten draaien? EU-hosting per aanbieder (2026)
Veelgestelde vragen
Antwoorden op vragen over Open-weight AI (Llama 4, Mistral, Qwen, gpt-oss, DeepSeek) vs. Commerciële API (Claude, GPT, Gemini)
In vier harde situaties: als geen enkele externe partij je data mag zien, als de toepassing offline moet werken, als je een finetune wilt bezitten en als je het model in een eigen product inbakt zonder licentie van een aanbieder. Daarbuiten is het een afweging van kwaliteit, beheer en tooling, en die valt voor de meeste MKB-bedrijven uit naar een commerciële API of een gehoste open-weight API.
Via een gehoste API in de EU wel: gpt-oss-120B kost bij Scaleway €0,15 in en €0,60 uit per miljoen tokens, tegenover $2 en $10 voor Claude Sonnet 5; alleen OpenAI’s kleinste model GPT-6 Luna is sinds 22 september 2026 met $0,10 en $0,50 goedkoper. Op een eigen GPU niet bij MKB-volumes: één H100 kost €1.940 per maand, en dat wordt bij een mix van 15 miljoen in en 5 miljoen uit pas boven 550 miljoen tokens per maand goedkoper dan Sonnet 5. Kosten zijn dus zelden de reden om zelf te hosten.
Open-source in de strikte zin betekent dat code, trainingsproces en liefst ook de data openbaar zijn; vrijwel geen zakelijk relevant model haalt dat. Open-weight betekent dat je alleen de getrainde gewichten krijgt, onder een licentie die bepaalt wat je ermee mag. Voor de keuze op deze pagina telt die licentie, niet de naam.
Ja, onder de Llama 4 Community License: commercieel gebruik, aanpassen en verspreiden zijn toegestaan, met naamsvermelding. Alleen wie op de releasedatum meer dan 700 miljoen maandelijkse gebruikers had, moet Meta om een aparte licentie vragen. Wil je die voorwaarde helemaal niet, kies dan een model onder Apache 2.0 zoals Mistral Small 4, Qwen 3.8 of gpt-oss.
Qwen 3.8, gpt-oss 20B en 120B, Mistral Small 4 en Medium 3.5 plus Large 3, DeepSeek V4 Pro en V4.1 Flash, en Llama 4 Scout en Maverick. Welke GPU elk model nodig heeft en wat het per maand kost, staat op de kostenpagina over open-source AI-modellen zakelijk draaien.
Ja, via een Europese aanbieder die het model per token host, zoals Scaleway in Parijs, OVHcloud AI Endpoints of het EU-endpoint van Mistral. Je krijgt dan de licentievrijheid en de Europese locatie van open-weight zonder beheer, en de host tekent de verwerkersovereenkomst. Alleen de eis "geen enkele externe partij" is er niet mee te halen.
Iemand moet de inferentie-stack (vLLM of SGLang) installeren, drivers en modelversies bijhouden, monitoring inrichten en storingen opvangen. Hoeveel uur dat per maand is, hangt af van je beschikbaarheidseis en het aantal modellen; wij begroten het als een aparte post en bieden het als Managed AI vanaf €500 per maand. Wie die capaciteit niet heeft en niet wil inkopen, kiest een API.
Dat kan bij alle drie de grote aanbieders, maar alleen via een specifieke route: Claude via Google Vertex AI of AWS Bedrock in een EU-regio, OpenAI via eu.api.openai.com met 10% toeslag op modellen vanaf 5 maart 2026, Gemini via Vertex AI. Het blijft een Amerikaanse aanbieder met een Europese regio; wat dat juridisch betekent, lees je op de pagina over EU-hosting van AI-modellen.
Artikel 2 lid 12 stelt AI-systemen met een vrije of open-source licentie vrij van de verordening, tenzij ze als hoog-risicosysteem of onder artikel 5 of 50 op de markt komen. Die vrijstelling geldt voor de aanbieder van het model; wie een open model finetunt voor een bijlage III-toepassing, wordt zelf aanbieder van een hoog-risicosysteem. Voor interne tekstverwerking maakt open of gesloten voor de AI Act geen verschil.
Ja, en dat is de gebruikelijke eindstand: een commercieel model voor de stappen die kwaliteit vragen, een open model via een EU-API voor bulkwerk, en een eigen GPU uitsluitend waar data-eisen dat opleggen. Een router tussen je toepassing en de modellen stuurt elke taak naar de juiste route en vangt op wat de hoofdaanbieder wegvalt.
Haalbaar, maar reken op vier tot zes weken proefdraaien. Prompts reageren op een ander model anders, tool-definities verschillen per aanbieder en een finetune bij een aanbieder moet je op het open model opnieuw doen. Wie vanaf het begin een router en modelonafhankelijke prompts bouwt, houdt die overstap klein.
Omdat Opus 5 en Sonnet 5 in ons werk op documenten, code en agents het betrouwbaarst zijn en Claude Code en MCP de tooling meebrengen. Het is een kwaliteitskeuze die we per project toetsen; in de vijf situaties uit deze vergelijking adviseren we een open-weight model, en we bouwen elke toepassing zo dat het model te wisselen is.
Twijfel je welke kant op?
De gratis AI-scan geeft vaak meer duidelijkheid dan nog een blogpost. We kijken kosteloos mee naar jouw situatie en zeggen het eerlijk als je ons niet nodig hebt.