
RAG of fine-tuning: hoe krijg je je eigen kennis in een AI-model? (2026)
RAG, fine-tuning, lange context of een prompt? Beslistabel per doel, de fine-tuning-stand bij OpenAI, Google en Anthropic en een rekenvoorbeeld.
RAG (retrieval-augmented generation)
Fine-tuning (volledig of met LoRA-adapters)

Het redactieteam van CleverTech AI combineert expertise in AI, procesautomatisering en digitale transformatie. Alle content wordt opgesteld met behulp van AI-tools en zorgvuldig gecontroleerd op juistheid, actualiteit en praktische toepasbaarheid door tech-leads met ervaring in AI, procesautomatisering en IT-consulting.
Bijgewerkt op
Kort antwoord
Verandert je kennis of moet een antwoord een bron noemen, kies dan RAG: een zoeklaag haalt bij elke vraag de passende passages uit je eigen zoekindex. Fine-tuning wijzigt het gedrag van het model en loont uitsluitend voor een vaste toon, een strikt format of een classificatietaak met duizenden gelabelde voorbeelden. Past de complete kennisbasis in één prompt, dan volstaan een systeemprompt of lange context en hoef je niets te bouwen. Het rekenvoorbeeld rekent beide routes door voor 2.000 documenten en 5.000 vragen maandelijks, inclusief het gekrompen aanbod van doortrainen bij de grote modelmakers.
Waarom deze vergelijking?
Een taalmodel je eigen documenten laten kennen kan in 2026 langs minder wegen dan in 2025: van de vier grote modelmakers heeft nog maar één een actueel ondersteund tarief voor doortrainen, en het model achter onze zoeklagen mag je nergens fine-tunen. De vraag "RAG of fine-tuning?" verschuift zo naar: hoe krijg ik mijn kennis in een model met dichte gewichten?
Er zijn vier routes: kennis in de prompt zetten, een miljoen tokens in één aanroep meesturen, bij elke vraag de juiste passage laten ophalen (RAG), of het model doortrainen op eigen voorbeelden (fine-tuning).
Hier beslissen we die route per doel; definities en de complete kostentabel wonen op zusterpagina's.
Wat RAG is en wanneer je het nodig hebt legt de techniek uit; wat kost AI op je eigen data draagt de kostentabel.
Eerlijk vooraf: CleverTech AI werkt Claude-first, gunstig voor een zoeklaag en ongunstig voor doortrainen. Wint fine-tuning, dan noemen we in de tabel een ander model.
De andere vragen over modellen, abonnementen en AVG staan bij elkaar in de index AI-modellen vergelijken.
Wat kies je?
RAG (retrieval-augmented generation)
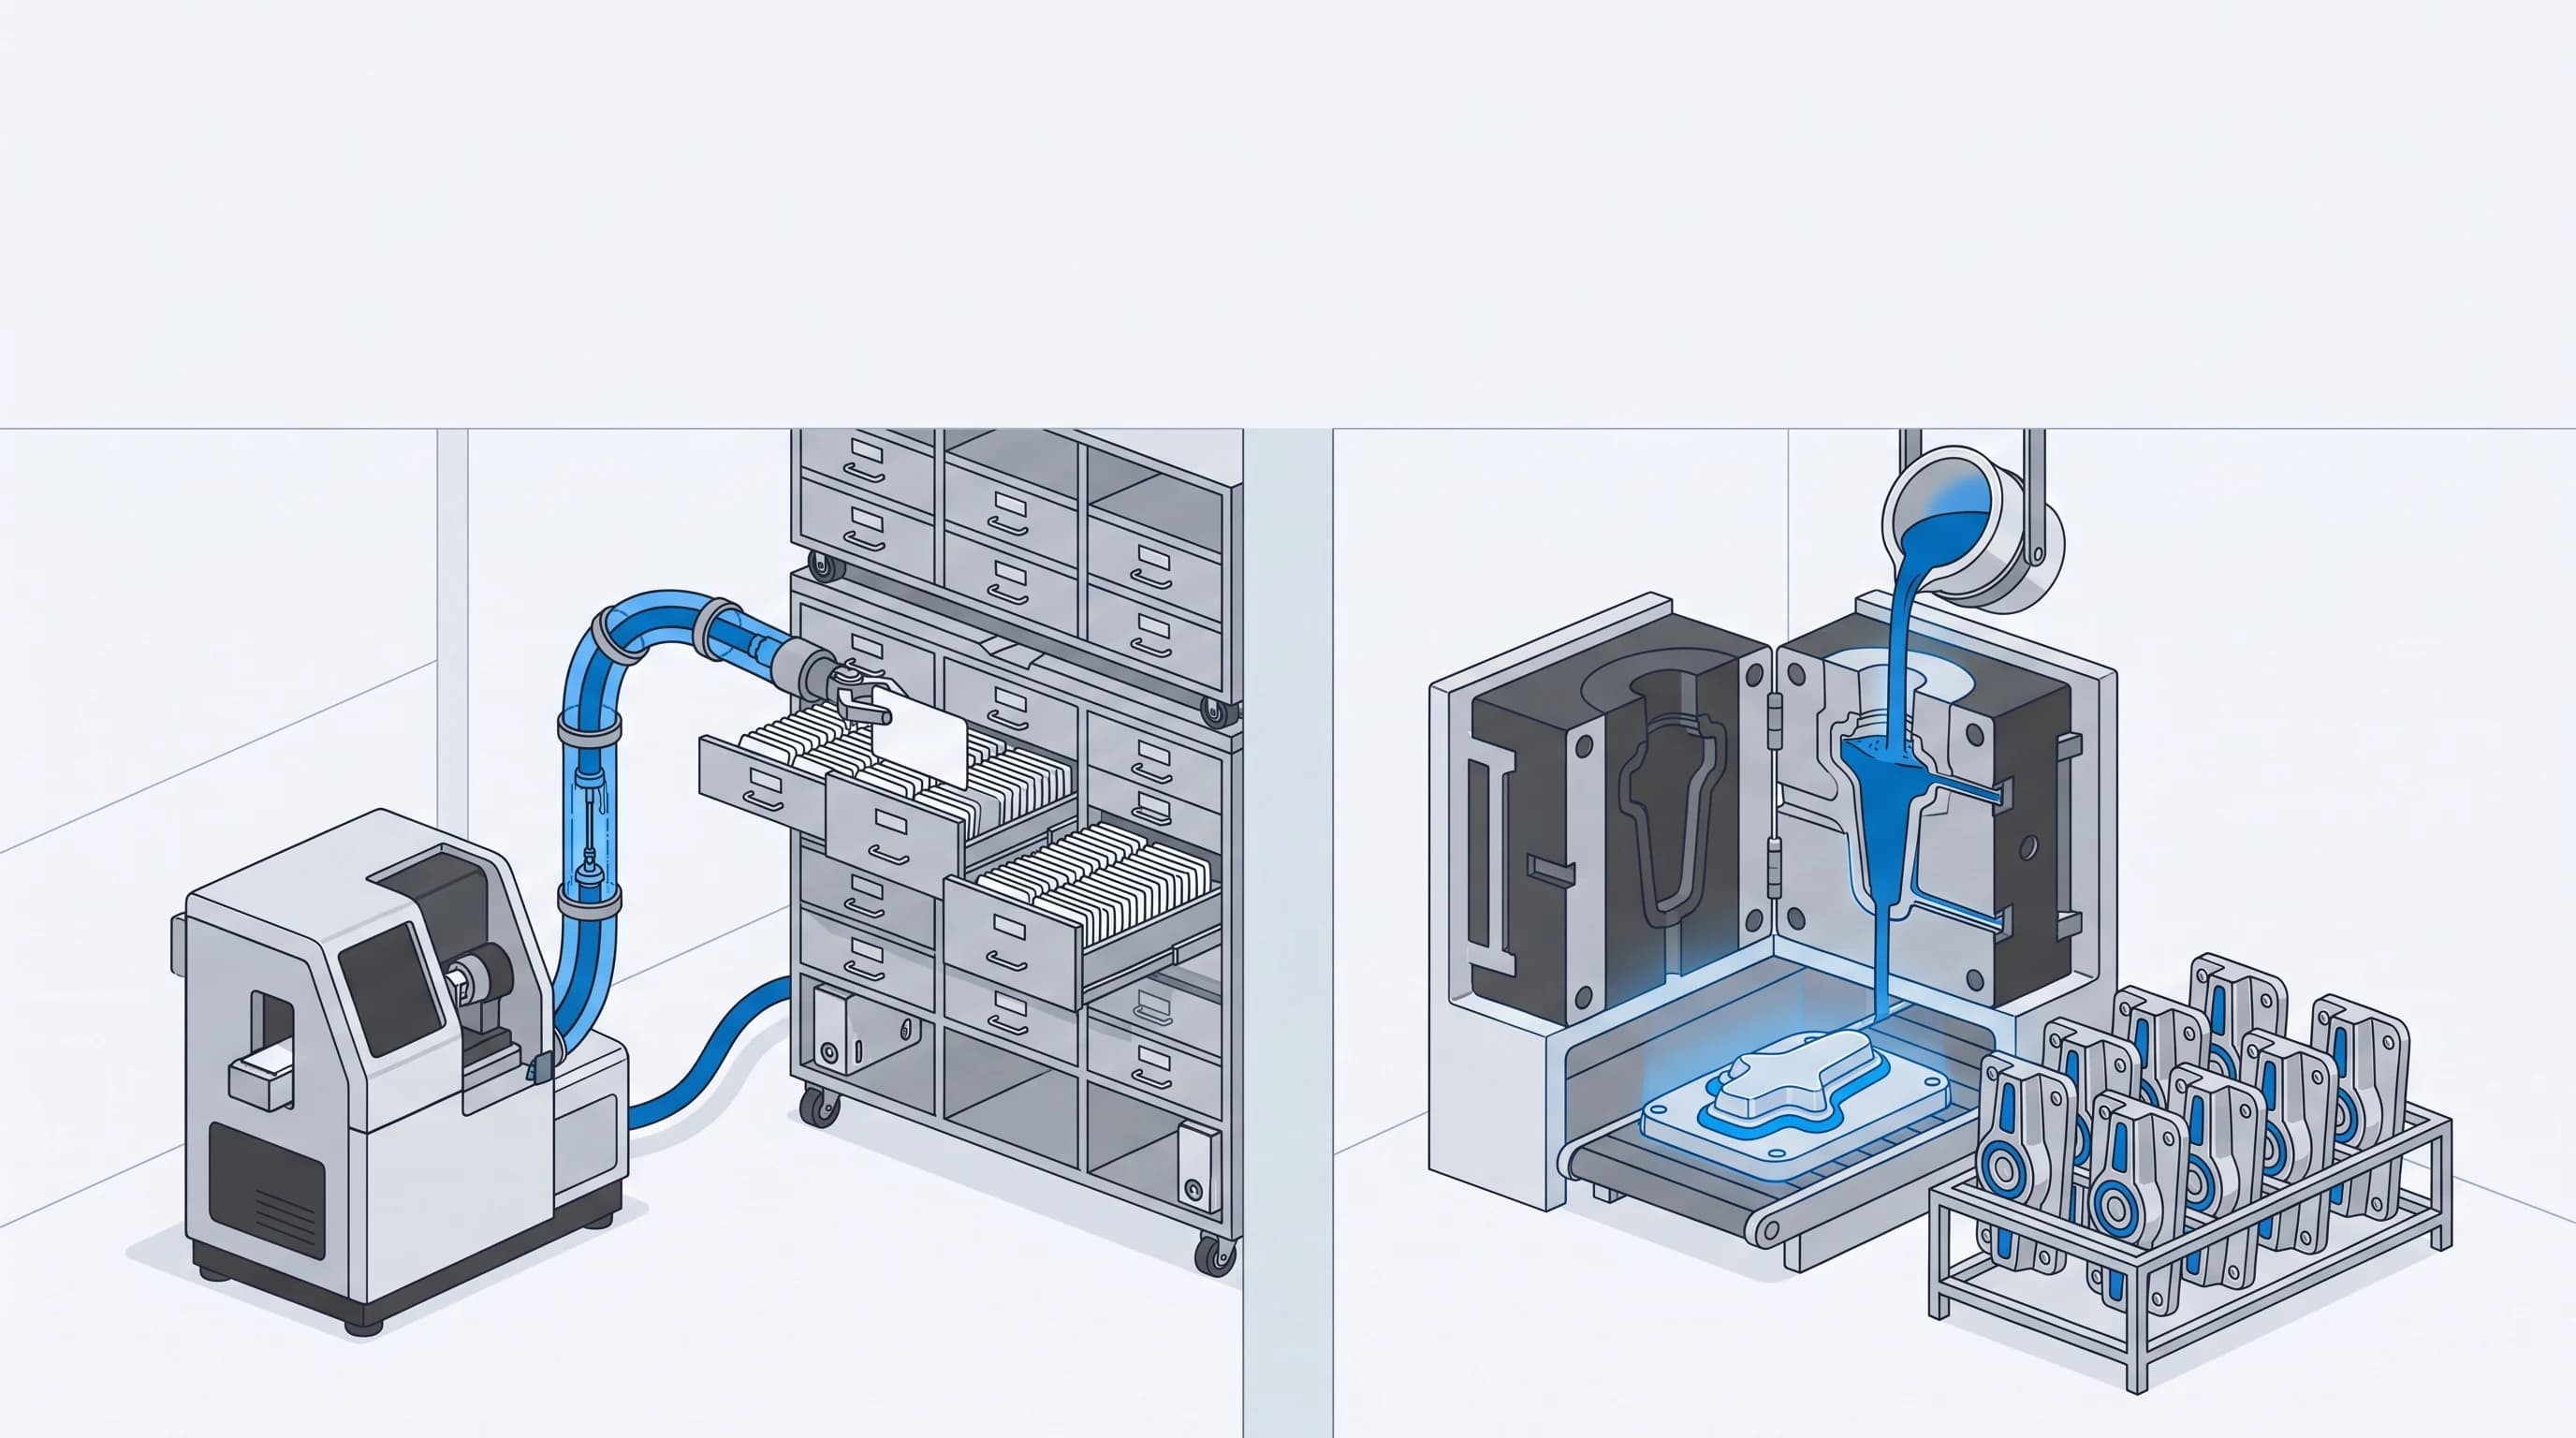
Het model blijft ongewijzigd; een zoeklaag haalt bij elke vraag de relevante passages uit je eigen documenten op en geeft die als context mee. De kennis leeft in je eigen database, het antwoord verwijst naar de passage.
- Nieuw of gewijzigd document meteen beschikbaar: indexeren is minuten, hertrainen is een project
- Elk antwoord herleidbaar naar een passage, precies wat een chatbot op bedrijfsdata en een AVG-verzoek nodig hebben
- Werkt met elk model, ook met Claude, dat zelf geen fine-tuning biedt; van model wisselen is een configuratieregel
- Verwijderen betekent verwijderen: haal het document uit de index en het model kent het niet meer
- Prompt caching drukt de vaste instructies naar 10 procent van de inputprijs (Anthropic, prompt caching)
- Eén model, één index per klant of afdeling: toegangsregels zitten in de zoeklaag, niet in het model
- Het antwoord is zo goed als de passage die wordt opgehaald: opschonen, opdelen en een evaluatieset bouwen zijn de echte kostenpost
- Elke vraag draagt duizenden contexttokens; bij hoge volumes is dat de grootste terugkerende post
- Toon en vorm stuur je alleen via instructies en voorbeelden in de prompt, niet in het model zelf
- Extra bewegende delen: embeddingmodel, vectoropslag, reranking en monitoring die je moet onderhouden
Fine-tuning (volledig of met LoRA-adapters)
Je traint een bestaand model door op eigen voorbeelden, meestal prompt-antwoordparen. Stijl, jargon en gedrag komen in de gewichten terecht; sinds LoRA (2021) kan dat met een fractie van de trainbare parameters.
- Stijl, structuur en vakjargon zitten in het model zelf, zonder lange instructies bij elke aanroep
- Kortere prompts per vraag: geen opgehaalde passages, dus minder tokens en lagere latency per aanroep
- Een klein doorgetraind model kan op één afgebakende taak een groot basismodel evenaren tegen een lager tarief per token
- LoRA traint tot 10.000 keer minder parameters dan volledige fine-tuning (Hu et al., 2021), waardoor een run op één gehuurde GPU past
- Volledige controle bij open-weight modellen: gewichten, adapter en hosting zijn van jou
- Kennis staat vast op het moment van trainen; elke wijziging vraagt een nieuwe run plus validatie
- Geen bronvermelding: het model weet niet meer uit welk document een zin kwam
- Een document "vergeten" kan alleen door opnieuw te trainen zonder dat document
- Bij de frontier-leveranciers krimpt het aanbod: OpenAI bouwt af, Mistral heeft afgeschreven, Anthropic alleen Claude 3 Haiku via Bedrock
- Datasetbouw is handwerk: duizenden voorbeelden schrijven, controleren en actueel houden
- Open-weight zelf hosten kost een GPU die 24 uur per dag doorloopt, ook bij tien vragen per dag
 Eigen product — CleverTech AI
AI-assistent op een eigen tekstcorpus met RAG (Bijbel Assistent)
4vertalingen als doorzoekbaar RAG-corpus
De harde vergelijking
| Kenmerk | RAG (retrieval-augmented generation) | Fine-tuning (volledig of met LoRA-adapters) |
|---|---|---|
| Waar leeft de kennis | In je eigen database, buiten het model | In de gewichten van het model |
| Kennis die wekelijks verandert | Document toevoegen of vervangen, direct actief | Nieuwe trainingsrun en validatie |
| Antwoord met bron | Ingebouwd: de opgehaalde passage is de bron | Niet mogelijk |
| Vaste schrijfstijl en format | Via instructies en voorbeelden in de prompt | In het model zelf |
| Classificatie met duizenden voorbeelden | Alleen via voorbeelden in de prompt | Kernsterkte, ook op een klein model |
| Vakjargon | Meegeleverd in de opgehaalde passages | Aangeleerd |
| Tokens per vraag | Duizenden contexttokens per vraag | Alleen de vraag en het antwoord |
| Vaste kosten vooraf | Bouw van de zoeklaag en evaluatieset | Dataset, trainingsrun(s), bij open-weight ook GPU-hosting |
| AVG: document verwijderen | Uit de index halen | Opnieuw trainen zonder dat document |
| Modelkeuze | Elk model, ook Claude Sonnet 5 en Opus 5 | Alleen modellen waarvan de leverancier training toestaat |
| Beschikbaar bij Anthropic (18-09-2026) | Ja, op elk Claude-model | Alleen Claude 3 Haiku via Amazon Bedrock |
| Beschikbaar bij OpenAI (18-09-2026) | Ja, op elk model | Niet voor nieuwe klanten; bestaande klanten tot 6 januari 2027 |
| Beschikbaar bij Google (18-09-2026) | Ja, op elk model | Gemini 3.5 Flash en 3.1 Flash Lite op Vertex AI, lijstprijs publiek |
| Beschikbaar bij Mistral (18-09-2026) | Ja | Documentatie op "deprecated"; open-weight modellen wél zelf te trainen |
| Rekenvoorbeeld 2.000 documenten, 5.000 vragen per maand | Circa €91 per maand op Sonnet 5 plus VPS | Circa €28 per maand op tuned Gemini 3.5 Flash, of €1.940 per maand voor een eigen H100 |
Vier routes, één vraag: waar leeft de kennis?
Voor je RAG en fine-tuning tegen elkaar afweegt, hoort de goedkoopste route eerst: niets bouwen.
- Systeemprompt. Je zet de kennis letterlijk in de instructie. Werkt voor een prijslijst, een stijlgids of een set regels van hooguit enkele tientallen pagina's.
- Lange context. Je geeft het hele document of dossier mee in één aanroep. Claude Sonnet 5 en Opus 5 rekenen tot 1 miljoen tokens het standaardtarief; welk model dat het best doet, staat op welk AI-model leest lange documenten het best.
- RAG. Een zoeklaag haalt per vraag de juiste passages op. Nodig zodra de kennisbank groter is dan wat je per vraag wilt meesturen, of vaak verandert.
- Fine-tuning. Je traint een model door op voorbeelden. Nodig als niet de kennis maar het gedrag moet veranderen: toon, structuur, een classificatie.
De volgorde is geen toeval: elke stap naar rechts kost meer bouwwerk en meer onderhoud. Wie bij lange context al klaar is, hoeft de rest van deze pagina niet.
Een vijfde route, live gegevens uit je systemen via een MCP-koppeling in plaats van documenten, valt buiten deze vergelijking; die staat op wat kost een MCP-server.
Beslistabel: welke route per doel
Onze eigen beslistabel, opgebouwd uit onze eigen projecten op eigen data, waaronder Bijbel Assistent. Per doel staat de route die wij als eerste proberen.
| Doel | Systeemprompt of lange context | RAG | Fine-tuning |
|---|---|---|---|
| Kennis die wekelijks of dagelijks verandert | Alleen als alles in één prompt past | Eerste keus | Ongeschikt: elke wijziging is een run |
| Antwoord met controleerbare bron | Ja, het document staat in de prompt | Ingebouwd | Niet mogelijk |
| Vaste schrijfstijl of huisstijl | Eerste keus: voorbeelden in de prompt | Nee, RAG stuurt geen toon | Pas als de prompt niet consistent genoeg is |
| Vast uitvoerformat (JSON, sjabloon) | Eerste keus: schema in de prompt | Nee | Alleen bij zeer strikte eisen op een klein model |
| Classificatie of extractie met duizenden gelabelde voorbeelden | Tot enkele tientallen voorbeelden | Nee | Eerste keus, vaak op een klein model |
| Vakjargon en afkortingen | Woordenlijst in de prompt | Jargon komt mee in de passages | Ja, maar de woordenlijst is goedkoper |
| Laagste kosten per vraag bij hoog volume | Hoog: de hele context telt per vraag | Middel: passages tellen per vraag | Laagste per vraag, hoogste vooraf |
| Minste onderhoud | Tekst aanpassen | Documenten en evaluatieset bijhouden | Hertrainen, hervalideren, adapter beheren |
| AVG: document of persoon verwijderen | Uit de prompt halen | Uit de index halen | Opnieuw trainen zonder dat materiaal |
| Model van Anthropic gebruiken | Ja | Ja | Alleen Claude 3 Haiku via Bedrock |
Twee patronen komen in vrijwel elk traject terug. Kennis hoort in RAG of in de prompt, gedrag hoort in de prompt en pas daarna in fine-tuning.
En de combinatie bestaat: een klein doorgetraind model voor de toon, met RAG voor de feiten. Bouw die pas als de prompt-variant aantoonbaar tekortschiet, want twee lagen betekent twee keer onderhoud.
De stand van fine-tuning bij de leveranciers op 18 september 2026
Dit is de tabel die de keuze in 2026 het meest bepaalt. Alle regels zijn op 18 september 2026 van de leverancierspagina's afgelezen; dollarbedragen staan omgerekend naar euro tegen de referentiekoers die de ECB voor 18 september 2026 publiceerde, 1,1460 dollar per euro (ECB), exclusief btw.
| Leverancier | Fine-tuning beschikbaar? | Trainingsprijs | Prijs van het getrainde model | Bron |
|---|---|---|---|---|
| OpenAI | Aangekondigd op 7 mei 2026, van kracht sinds 2 juli 2026: geen nieuwe trainingsopdrachten voor organisaties zonder inferentie op een fine-tuned model in de afgelopen 60 dagen; bestaande klanten kunnen tot 6 januari 2027 nieuwe runs starten | Alleen nog o4-mini op de prijspagina: $100 per trainingsuur (circa €87) | Inferentie op bestaande fine-tunes blijft tot het basismodel wordt uitgefaseerd | OpenAI pricing, OpenAI deprecations |
| Google (Vertex AI) | Ja: Gemini 3.5 Flash (supervised en reinforcement) en Gemini 3.1 Flash Lite (supervised) | Gemini 3.5 Flash $0,01 per 1.000 trainingstokens, dus $10 per miljoen (circa €8,73); 3.1 Flash Lite $0,003 per 1.000 | Vanaf Gemini 3 kost het getrainde endpoint 1,5 keer het basistarief: voor 3.5 Flash $2,25 in en $13,50 uit per miljoen | Vertex AI pricing |
| Google (open modellen op Vertex) | Ja: Llama 3.3 70B, Llama 4 Scout, Qwen 3 en Gemma 3 | Bijvoorbeeld Llama 3.3 70B $6,72 en Qwen 3 8B $4,18 per miljoen trainingstokens | Afhankelijk van de gekozen hosting | Vertex AI pricing |
| Mistral | De fine-tuning-documentatie staat op "deprecated" en wordt niet meer actief ondersteund | Alleen legacy-tarieven in de gearchiveerde docs: minimaal $4 per trainingsopdracht plus $2 per maand opslag per model | Open-weight modellen (Small 4, Large 3) mag je wél zelf trainen onder Apache 2.0 (Mistral modeloverzicht) | Mistral docs |
| Anthropic | Alleen Claude 3 Haiku, uitsluitend in Amazon Bedrock (algemeen beschikbaar sinds 1 november 2024, regio US West Oregon, tot 32K tokens context); geen fine-tuning op de eigen Claude API en niet op Haiku 4.5, Sonnet 5 of Opus 5 | Staat op de Bedrock-prijspagina, die alleen in de browser laadt; wij citeren hem daarom niet | Idem | Anthropic |
| Open-weight op een gehuurde GPU | Ja, alles wat de licentie toestaat (Llama 4, DeepSeek V4, Mistral, Qwen, gpt-oss) | GPU-uren van de run; een H100 met 80 GB kost bij OVHcloud in Gravelines €1.940 per maand | Dezelfde GPU, 24 uur per dag, zolang het model live staat | OVHcloud prijzen |
De conclusie uit de tabel is ongemakkelijk voor wie fine-tuning met een topmodel in gedachten had. Het topmodel van OpenAI, Anthropic en Mistral kun je in september 2026 nergens doortrainen; alleen Google houdt een lijstprijs voor een klein Gemini-model.
Wie fine-tuning echt nodig heeft, komt dus uit bij Gemini Flash op Vertex of bij een open-weight model dat je zelf host. Welke open-weight modellen daarvoor in aanmerking komen en wat de EU-hosting kost, staat op open-source AI-modellen zakelijk draaien.
Voor Claude-first bouwers zoals wij is dit de eerlijke consequentie: onze RAG-laag draait op Claude, maar een fine-tuned classificatiemodel bouwen we op Gemini of open-weight, niet op Claude.
Rekenvoorbeeld: 2.000 documenten, 5.000 vragen per maand
Dit is een rekenvoorbeeld op de lijstprijzen hierboven, geen klantmeting. Het scenario: een kennisbank van 2.000 documenten van gemiddeld 2.000 tokens (circa vijf pagina's), 5.000 vragen per maand, antwoorden in het Nederlands.
De RAG-aannames zijn dezelfde als op onze kostenpagina voor AI op eigen data: 6.000 input- en 400 outputtokens per vraag, Claude Sonnet 5 als antwoordmodel ($2 in, $10 uit per miljoen tokens, Anthropic pricing), embeddings via OpenAI text-embedding-3-small ($0,02 per miljoen, OpenAI pricing) en pgvector op een kleine VPS.
Voor fine-tuning nemen we aan dat je uit die documenten 5.000 prompt-antwoordparen van 1.500 tokens maakt en drie epochs traint: 22,5 miljoen trainingstokens per run, vier runs per jaar. Per vraag gaan er dan 500 tokens in en 400 uit, zonder opgehaalde passages.
| Post | RAG op Claude Sonnet 5 | Fine-tuning op Gemini 3.5 Flash (Vertex) | LoRA op open-weight, eigen H100 |
|---|---|---|---|
| Bouw (onze prijsband) | RAG-zoeken over meerdere bronnen vanaf €12.500 | AI-feature vanaf €8.500, exclusief het schrijven van de 5.000 voorbeelden | AI-feature vanaf €8.500, exclusief voorbeelden en GPU-inrichting |
| Eenmalig indexeren of trainen | 4 miljoen tokens embedden: $0,08 | 22,5 miljoen trainingstokens: $225 (circa €196) per run | GPU-uren van de run vallen binnen de maandhuur |
| Terugkerend trainen of herindexeren | Gewijzigde documenten opnieuw embedden: minder dan €1 per maand | Vier runs per jaar: $900 (circa €785) | Vier runs per jaar: binnen de maandhuur |
| Tokens per maand | 5.000 x $0,016 = $80 (circa €70) | 5.000 x $0,0065 = $32,60 (circa €28) | €0, de GPU is al betaald |
| Hosting per maand | VPS met pgvector: circa €21 | €0, het endpoint is serverless (alleen-EU-inferentie kost $1,65 en $9,90 per miljoen, dan circa €31 aan tokens) | €1.940 voor één H100 bij OVHcloud |
| Totaal per maand na de bouw | circa €91 | circa €28, plus circa €65 per maand aan runs | €1.940 |
| Kennis bijgewerkt | Direct | Op zijn best per kwartaal | Op zijn best per kwartaal |
| Antwoord met bron | Ja | Nee | Nee |
Drie dingen vallen op. Fine-tuning op Gemini is per maand het goedkoopst, maar levert een model dat drie maanden achterloopt en geen bron noemt; voor een kennisbank is dat een verkeerde besparing.
De eigen H100 is pas verdedigbaar bij een volume dat twintig keer zo groot is, of bij een harde eis dat geen enkele token het eigen datacenter verlaat; die afweging staat op ChatGPT Enterprise tegenover private AI.
En bij alle drie is de bouw de grootste post, niet het model. Onderhoud komt daar bij: vanaf €750 per maand plus modelkosten voor een AI-applicatie (prijsband uit onze dienst AI-software laten maken); een RAG-laag rond één afgebakende bron start bij €7.500 in plaats van €12.500.
Hoe wij het zelf deden: Bijbel Assistent
Ons eigen product Bijbel Assistent is de case waar we deze keuze hardop maakten: een Nederlandstalige assistent op een corpus van vier Bijbelvertalingen, commentaren en grondtaal-lemma's, waar een verkeerd toegeschreven citaat binnen een minuut opvalt.
We kozen RAG en niet fine-tuning, om precies de twee redenen uit de beslistabel. Een doorgetraind model kan niet zeggen wáár iets staat, en elke wijziging in het corpus zou een nieuwe trainingsronde vragen.
De zoeklaag is PostgreSQL met pgvector, zodat corpus, gebruikersdata en embeddings in één systeem met dezelfde back-ups zitten; de Claude API is de redeneerlaag die de opgehaalde passages omzet in een antwoord met vertaling en commentaar erbij.
Het zwaartepunt van het werk lag vóór het chatvenster: corpus opschonen en opdelen, embeddings actueel houden en controleren of de assistent de juiste passage ophaalt. De hele opbouw staat in de case over Bijbel Assistent.
Zo kies je in een uur
Vier vragen, in deze volgorde, beslissen de route in de praktijk.
- Past alles in één prompt? Zo ja: systeemprompt of lange context, en je bent klaar.
- Moet het antwoord een bron noemen of verandert de kennis? Zo ja: RAG.
- Gaat het om gedrag in plaats van kennis? Stijl, format, classificatie: eerst voorbeelden in de prompt, pas daarna fine-tuning.
- Op welk model mag dat? Fine-tuning van een Claude-, GPT- of Mistral-topmodel is er niet; dan wordt het Gemini Flash op Vertex of open-weight.
Wil je dit voor je eigen documenten doorrekenen, bel dan 085 016 0118 of stuur een bericht via de contactpagina; we zeggen er ook bij wanneer een prompt volstaat en je niets hoeft te bouwen.
Twijfel je welke past bij jouw situatie? We denken vrijblijvend mee — RAG (retrieval-augmented generation) of Fine-tuning (volledig of met LoRA-adapters).
Wat kies je wanneer?
Het hangt af van je situatie
RAG wint voor kennis: alles wat verandert, alles wat een bron nodig heeft en alles wat je later moet kunnen verwijderen. Fine-tuning wint voor gedrag: een vaste stijl, een strikt format of een classificatie met duizenden voorbeelden op een klein model. In 2026 weegt daar de markt bij mee, want OpenAI bouwt fine-tuning af, Mistral heeft het afgeschreven en Anthropic biedt het alleen voor Claude 3 Haiku via Bedrock; wie fine-tuning nodig heeft, komt uit bij Gemini Flash op Vertex AI of een open-weight model.
Begin bij de goedkoopste route die werkt: een systeemprompt of lange context zolang de kennisbank in één aanroep past, RAG zodra dat niet meer zo is of een antwoord een bron moet hebben. Kies fine-tuning alleen als voorbeelden in de prompt aantoonbaar tekortschieten, en reken dan met Gemini 3.5 Flash op Vertex of een open-weight model op een gehuurde GPU. Combineer beide pas als de eerste laag in productie meetbaar knelt.
Opgesteld met AI-ondersteuning, geredigeerd en inhoudelijk verantwoord door het Redactieteam CleverTech AI.
Meer lezen
- DienstAI Software Ontwikkeling
- DienstAI-oplossingen & Integratie
- GidsAI-modellen vergelijken: welk model, wat het kost en wat mag
- ArtikelWat is RAG en wanneer heeft je bedrijf het nodig?
- ArtikelWat kost AI op je eigen data (RAG) in 2026?
- ArtikelWelk AI-model leest lange documenten het best (contracten, jaarverslagen, dossiers)?
Veelgestelde vragen
Antwoorden op vragen over RAG (retrieval-augmented generation) vs. Fine-tuning (volledig of met LoRA-adapters)
RAG verandert wat het model per vraag te lezen krijgt, fine-tuning verandert het model zelf. Bij RAG blijft je kennis in je eigen database staan en haalt een zoeklaag per vraag de juiste passages op; bij fine-tuning train je een model door op voorbeelden, zodat stijl en gedrag in de gewichten terechtkomen.
Per maand niet per se. In ons rekenvoorbeeld met 5.000 vragen per maand kost een fine-tuned Gemini 3.5 Flash circa €28 aan tokens tegenover circa €70 voor RAG op Claude Sonnet 5, omdat RAG per vraag duizenden contexttokens meestuurt. Tel je de trainingsruns, de datasetbouw en het gemis van bronvermelding mee, dan is RAG voor een kennisbank vrijwel altijd de betere koop; fine-tuning wordt pas goedkoper bij een stabiele taak en een hoog volume.
Op de eigen Claude API niet, en ook niet op Haiku 4.5, Sonnet 5 of Opus 5. Het enige Anthropic-model dat je mag doortrainen is Claude 3 Haiku, uitsluitend in Amazon Bedrock, algemeen beschikbaar sinds 1 november 2024 in de regio US West (Oregon). Wie Claude wil gebruiken, kiest daarom RAG of lange context; dat is ook onze eigen inrichting.
Nee. OpenAI heeft op 7 mei 2026 aangekondigd het zelfbedieningsplatform voor fine-tuning af te bouwen: nieuwe organisaties kunnen geen trainingsopdrachten meer starten, en bestaande klanten kunnen dat tot 6 januari 2027. Op de prijspagina staat alleen nog o4-mini met $100 per trainingsuur; bestaande fine-tunes blijven bruikbaar tot het basismodel wordt uitgefaseerd.
Bij de grote leveranciers alleen Google: Gemini 3.5 Flash en Gemini 3.1 Flash Lite op Vertex AI, met een publieke lijstprijs van $0,01 respectievelijk $0,003 per 1.000 trainingstokens. Daarnaast elk open-weight model waarvan de licentie het toestaat, zoals Llama 4, DeepSeek V4, Mistral Small 4 en Qwen, op Vertex of op een eigen gehuurde GPU.
Zolang de kennis in één aanroep past en je per vraag bereid bent die mee te sturen. Een stijlgids, een prijslijst of één contract van honderd pagina’s hoort in de prompt, niet in een zoeklaag; Claude Sonnet 5 en Opus 5 rekenen tot 1 miljoen tokens het standaardtarief. Bouw pas RAG als de kennisbank groter is dan dat, of als een antwoord een precieze bron moet noemen.
De leveranciers geven geen vast minimum, en wij ook niet. In de praktijk begin je bij honderden goede prompt-antwoordparen voor stijl en bij duizenden voor een classificatietaak, en telt kwaliteit zwaarder dan aantal. Het schrijven en controleren van die voorbeelden is de grootste post van een fine-tuning-traject, groter dan de trainingsrun zelf.
LoRA (Low-Rank Adaptation) traint niet alle gewichten van het model, maar een kleine adapter ernaast. Volgens het oorspronkelijke paper van Hu et al. uit 2021 scheelt dat tot 10.000 keer in het aantal trainbare parameters, waardoor een run op één GPU past en je per taak een aparte adapter kunt bewaren. Het lost het kennisprobleem niet op: ook een LoRA-adapter staat vast op het moment van trainen.
Bij RAG is een verwijderverzoek een databewerking: haal het document uit de index en het model kan er niet meer uit putten. Bij fine-tuning zit de informatie in de gewichten en is de enige zekere route opnieuw trainen zonder dat materiaal. Waar de data mag draaien is een aparte vraag; onze verwerkersovereenkomst-pagina’s per leverancier staan in de index AI-modellen vergelijken.
Ja: een klein doorgetraind model voor toon of format, met een RAG-laag voor de feiten en de bronvermelding. Het is de juiste eindstand voor bijvoorbeeld een klantenservice die in een strikte huisstijl moet antwoorden op een kennisbank die verandert. Bouw het pas als de prompt-variant aantoonbaar tekortschiet, want twee lagen betekent twee keer onderhoud en twee keer evalueren.
RAG, vrijwel zonder uitzondering. De antwoorden komen uit voorwaarden, productinformatie en procedures die veranderen, en een klant wil kunnen zien waar het antwoord vandaan komt. Toon en huisstijl regel je in de systeemprompt; alleen als dat na een paar iteraties niet consistent genoeg is, komt een kleine fine-tuned laag voor de toon in beeld.
Voor een RAG-laag rond één afgebakende bron rekenen wij vanaf €7.500 eenmalig; RAG-zoeken over meerdere bronnen met toegangsregels en evaluatieset vanaf €12.500, steeds tegen een vaste prijs na scoping. Onderhoud van een AI-applicatie kost vanaf €750 per maand plus modelkosten. De volledige opbouw per post, inclusief hosting en tokens, staat op onze kostenpagina voor AI op eigen data.
Nee. Claude, GPT, Gemini en Mistral schrijven zonder training correct Nederlands; het verschil zit in toon en vakjargon, en dat stuur je met een systeemprompt en een woordenlijst. Fine-tuning voor Nederlands is alleen aan de orde bij een klein open-weight model dat je om andere redenen zelf host en dat in het Nederlands zichtbaar tekortschiet.
Twijfel je welke kant op?
De gratis AI-scan geeft vaak meer duidelijkheid dan nog een blogpost. We kijken kosteloos mee naar jouw situatie en zeggen het eerlijk als je ons niet nodig hebt.