Kort antwoord
AI inbouwen in bedrijfssoftware komt neer op vijf patronen: classificatie, extractie, RAG, agent en voorspelling. Bouw ze in de volgorde van meetbaar naar onomkeerbaar — begin bij extractie of classificatie, want die meet je binnen twee weken tegen een antwoord dat je zelf kent, en eindig bij de agent, het enige patroon waarbij een fout geen suggestie is maar een mutatie in je systeem. Elk patroon vraagt een andere modelklasse en schaalt anders in kosten: classificatie lineair met je volume, extractie met beeld, RAG met de opgehaalde passages en de agent met het aantal beurten. Kies het eerste patroon daarom niet op techniek maar op wat er vandaag door mensenhanden gaat.
Van lezen naar doen.
 Eigen product — CleverTech AI
AI-assistent op een eigen tekstcorpus met RAG (Bijbel Assistent)
4vertalingen als doorzoekbaar RAG-corpus
AI inbouwen in bedrijfssoftware komt in de praktijk neer op vijf patronen — classificatie, extractie, RAG, agent en voorspelling — en de volgorde waarin je ze bouwt doet meer voor je resultaat dan de keuze zelf.
Bijna elk gesprek begint bij de agent, omdat die het meest indruk maakt. Wij adviseren bijna altijd om daar te eindigen.
De reden is niet techniek maar meetbaarheid. Vier van de vijf patronen laten binnen een week zien of ze werken; de agent is het enige patroon waarbij een fout geen suggestie is maar een mutatie in je systeem.
Welke vórm je kiest — een AI-laag op je pakket, AI in eigen software, een agent of AI in de koppeling — staat in de beslisgids software met AI. Deze pagina gaat een laag dieper: per patroon wat het vraagt, wat het kost en waar het stukgaat.
De volgorde: van meetbaar naar onomkeerbaar
Er is één as waarop de vijf patronen echt verschillen, en dat is niet de prijs. Het is hoe snel je weet dat het misgaat, en wat een fout dan al heeft aangericht.
Op die as ligt de bouwvolgorde vast:
- Extractie — je meet per veld, tegen een document waarvan jij het juiste antwoord kent.
- Classificatie — even meetbaar, maar een verkeerde sortering valt pas verderop in het proces op.
- RAG — meetbaar op het ophalen, niet op het antwoord; dat is precies de verwarring.
- Voorspelling — je weet het pas zeker als de toekomst er is.
- Agent — schrijfrechten in je systemen; de fout is geen advies maar een boeking.
Die volgorde is ook wat Nederlandse bedrijven feitelijk doen. Van de bedrijven met 10 of meer werkzame personen gebruikte in 2025 22% text mining en 16% natural language generation, tegen 14% en 12% een jaar eerder (CBS).
Tekst analyseren komt dus vóór tekst genereren. Dat is geen toeval: analyseren kun je nakijken.
Classificatie: goedkoop te bouwen, lastig te vertrouwen
Classificatie sorteert een binnenkomende stroom op type, urgentie of route. Denk aan meldingen, aanvragen, mails of tickets die nu door een mens worden verdeeld.
Het past zodra je tientallen tot honderden items per dag hebt en de formulering elke keer anders is. Zijn de velden vast, dan is een regel goedkoper en voorspelbaar.
Een klein, snel model volstaat hier bijna altijd. Zwaarder inzetten kost geld zonder dat de sortering beter wordt, omdat de moeilijkheid in je eigen labels zit en niet in het redeneervermogen.
Als AI-laag op je bestaande pakket start een losse module bij €2.500 eenmalig en een complete implementatie bij €7.500, met €597 tot €2.497 per maand. Bouw je de classificatie ín je eigen software, dan begint één ingebouwde AI-feature bij €8.500.
Waar het misgaat. Niet bij de fout zelf, maar bij het vertrouwen dat je erin stelt. Onderzoek naar zelfgerapporteerde zekerheid is daarover ongemakkelijk duidelijk: taalmodellen zijn "often not just wrong, but confidently wrong" en verwoorden bij foute antwoorden juist hoge zekerheid in plaats van twijfel (Zhao e.a., 2026).
Een score die het model zelf noemt is dus geen drempel. Je drempel komt uit een gelabelde set uit je eigen historie, en je meet per klasse — want de zeldzame klasse is de klasse die stilletjes verkeerd gaat.
Wij draaien dit patroon in het huurdersportaal: binnenkomende onderhoudsmeldingen worden automatisch ingedeeld op categorie en prioriteit, naast de statusworkflow die elke melding een eigenaar geeft.
Extractie en OCR: het enige patroon met een eerlijke prijs per document
Extractie leest velden uit facturen, bonnen, formulieren of foto's. Het is het enige patroon waarbij je de businesscase op één regel kunt zetten.
Handmatig invoeren kost €4 tot €6 per document; met automatische uitlezing zakt dat naar €0,10 tot €0,35. Vanaf ongeveer 100 documenten per maand is de investering in zes tot tien weken terugverdiend.
Documentherkenning start bij €2.500 setup plus €150 tot €400 per maand. Eén documenttype met boekhoudkoppeling kost €2.500 tot €4.000, meerdere documenttypen met matching €4.000 tot €8.000.
Het model moet beelden aankunnen, wat de tokenrekening anders maakt dan bij platte tekst — daarover verderop meer.
Het faalpunt. Een getal dat het model niet zag maar toch invulde. Een leeg veld herstel je; een verkeerd gelezen bedrag schuift door de keten en komt terug als creditnota of verkeerde afrekening.
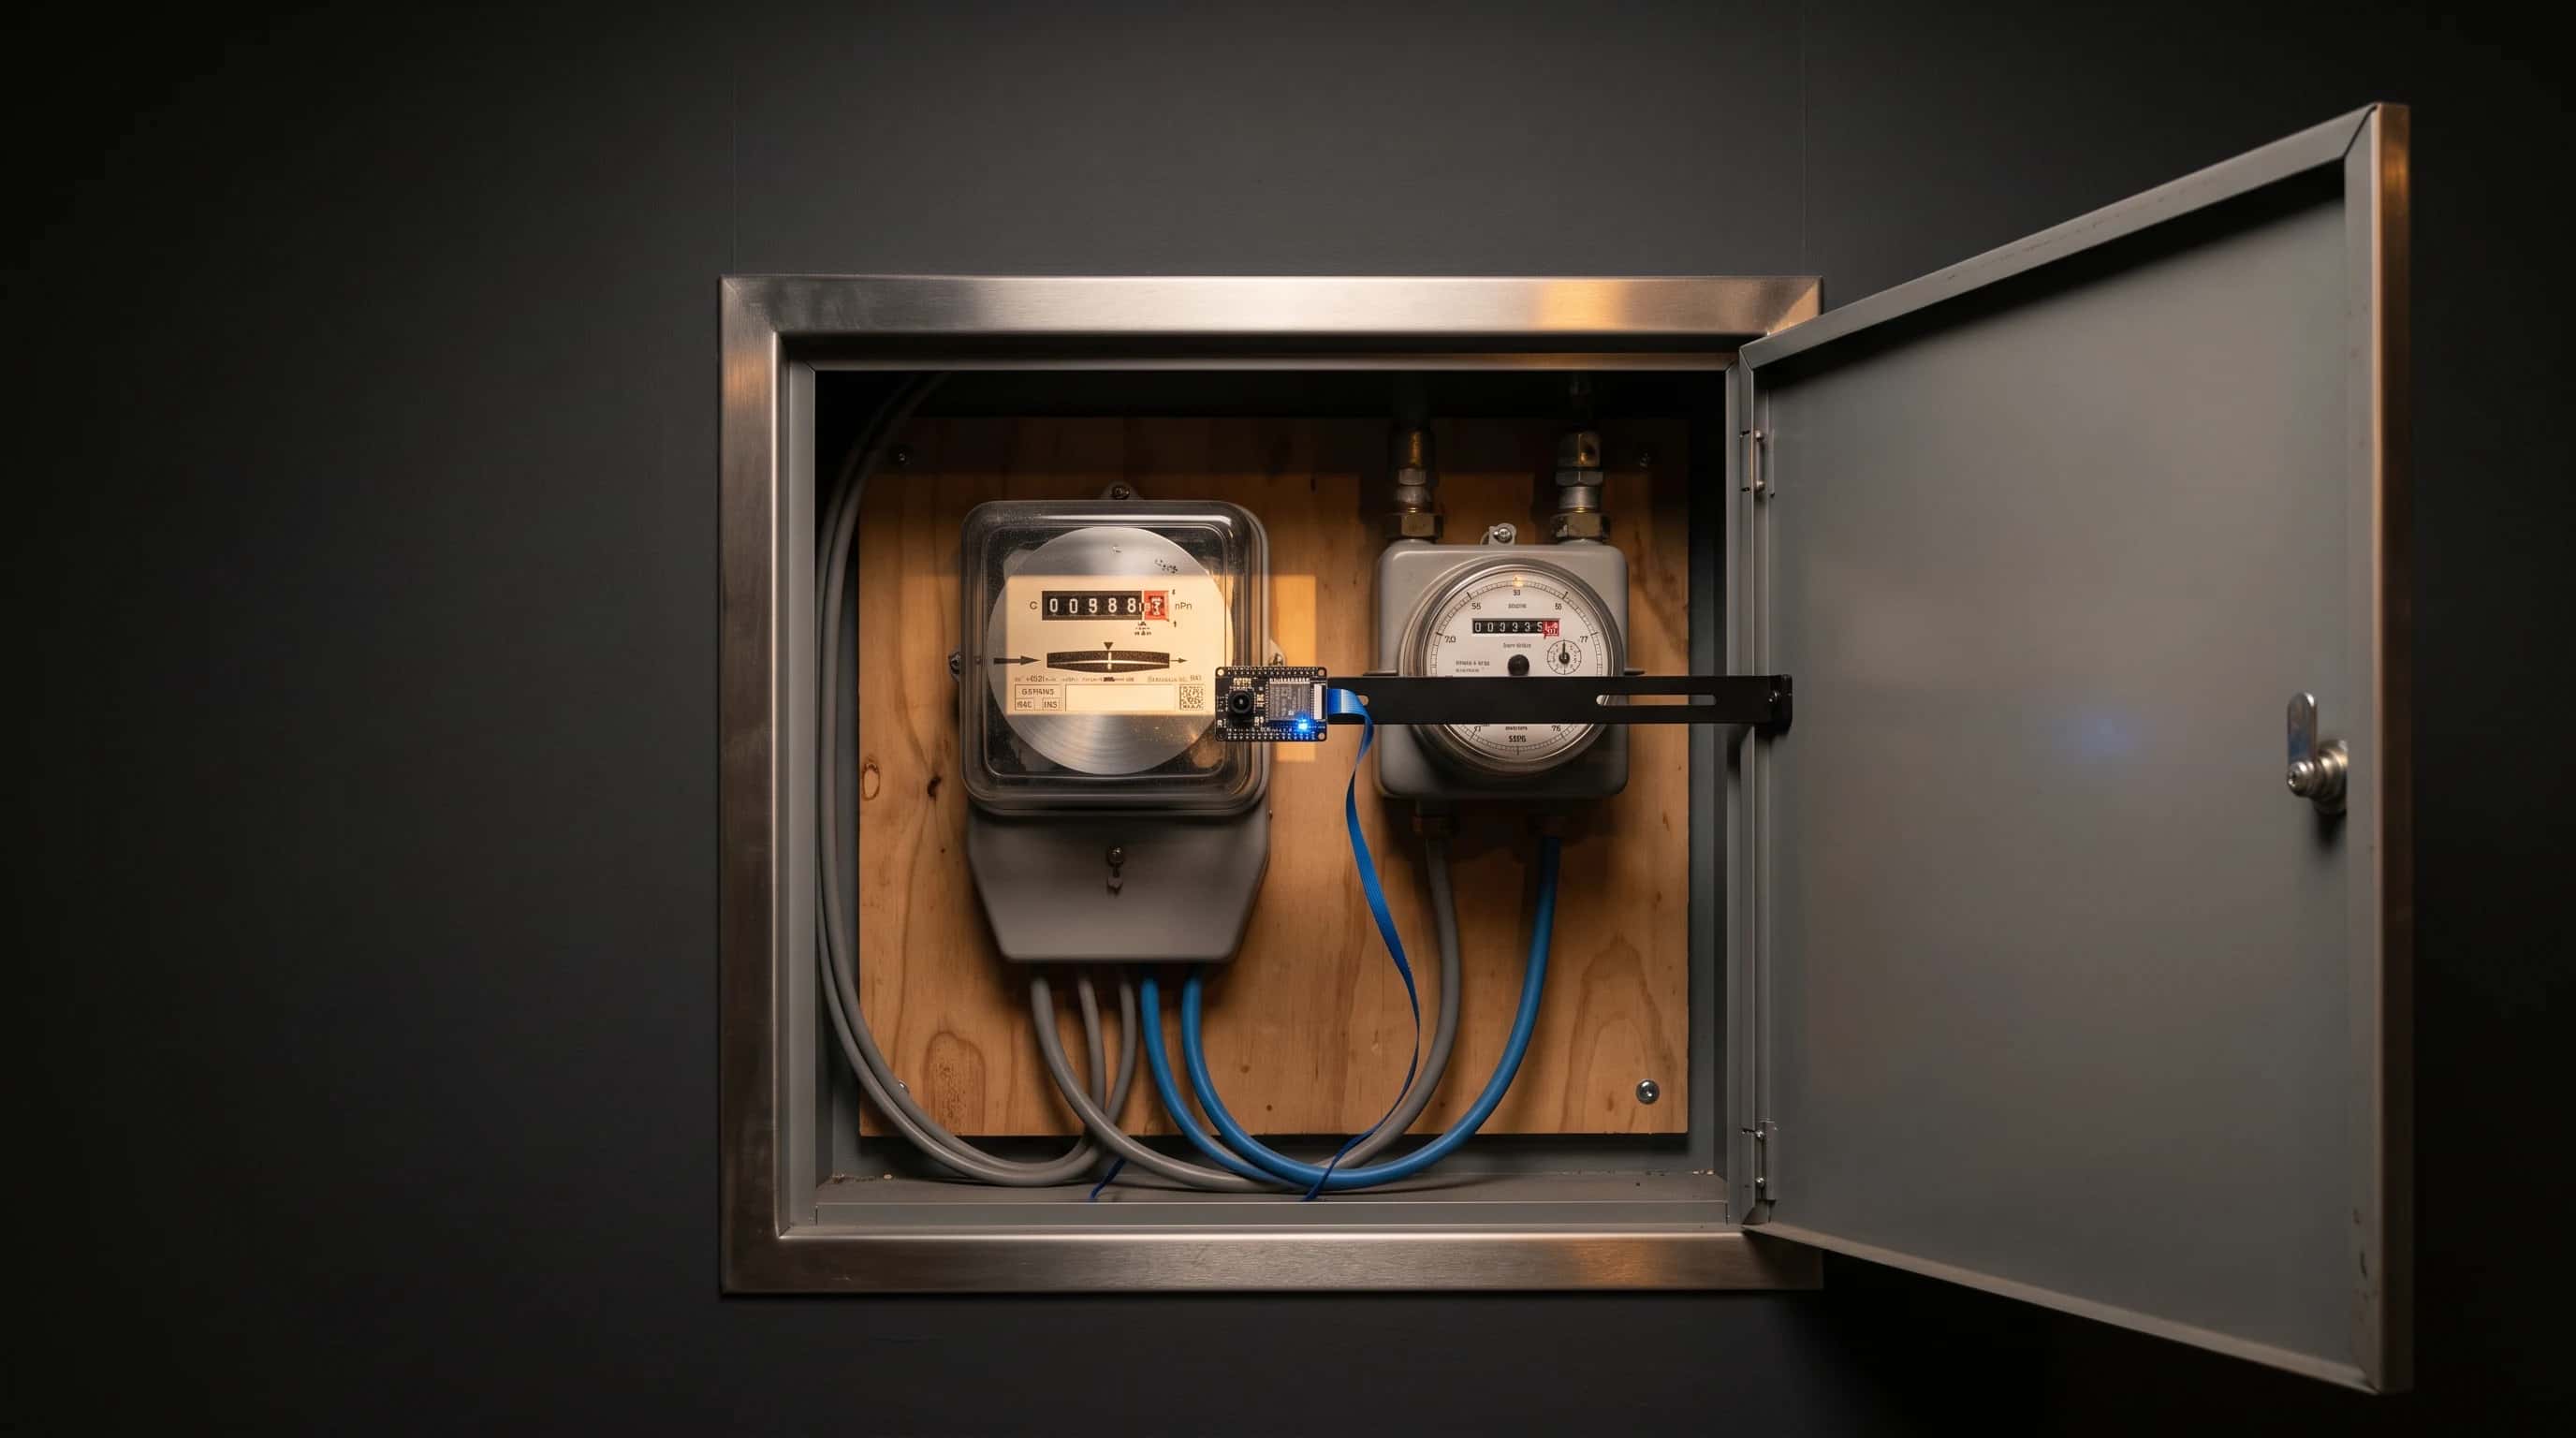
Daarom is de ontwerpregel bij ons productgedrag en geen richtlijn. In de meterstanden-case levert elke aflezing een waarde mét confidence-score, en bij een onleesbare foto — beslagen glas, tegenlicht van de flits — expliciet null met confidence 0.
Meet daarom per veld, niet per document. Wij starten elk traject met een proef op 30 tot 50 van je moeilijkste documenten en gaan pas verder bij 95%+ nauwkeurigheid per veld; na 30 tot 50 documenten per leverancier zit de herkenning boven 98%.
RAG: het ophalen faalt, niet het model
Een RAG-assistent beantwoordt vragen op je eigen documenten en verwijst naar de bron. Het past zodra kennis verandert en nu in hoofden en mappen zit.
Hier vraagt het patroon wél een zwaarder model, met een groot contextvenster: de opgehaalde passages moeten er allemaal in passen voordat er geredeneerd wordt.
AI op eigen data start bij €7.500 eenmalig plus €150 tot €600 per maand. Zit de assistent in software die je zelf laat bouwen, dan begint RAG-zoeken bij €12.500 via AI-software laten maken.
Waar het misgaat. Vrijwel nooit in de generatie. Een ervaringsrapport over drie RAG-systemen in onderzoek, onderwijs en biomedische toepassingen beschrijft zeven faalpunten, waarvan het tweede het meest verraderlijke is: "The answer to the question is in the document but did not rank highly enough to be returned to the user" (Barnett e.a., 2024).
Dezelfde auteurs concluderen dat validatie van een RAG-systeem "only feasible during operation" is. Je kunt de betrouwbaarheid dus niet vooraf ontwerpen; je meet hem terwijl hij draait.
Praktisch betekent dat: meet of de júiste passage is opgehaald, vóór je naar het antwoord kijkt. Een vlot antwoord op de verkeerde passage haalt elke antwoordgerichte test.
Onze eigen RAG-assistent op een tekstcorpus is daarop gebouwd, met PostgreSQL en pgvector in dezelfde database als de gebruikersdata. Het ontwerpdoel is dat elk inhoudelijk antwoord terug te voeren is op een aanwijsbare passage — in een genoemde vertaling, een commentaarregel of een grondtaal-lemma.
Of je überhaupt ophaalt of hertraint, is een aparte afweging: die staat in RAG vs. fine-tuning.
Agent: het enige patroon waarin een fout een mutatie is
Een agent voert een afgebakende taak uit in je systemen in plaats van erover te adviseren. Hij past bij een terugkerende handeling met een duidelijk begin en eind, vaker dan dagelijks.
Van alle vijf is dit het goedkoopste om te starten en het duurste om fout te doen. Een basis-agent kost €2.500 setup plus €350 per maand, een geavanceerde variant met meerdere koppelingen €4.500 plus €500 per maand, en een smalle agent met één taak start bij €1.500 setup.
Het model mag hier het sterkste zijn dat je je kunt veroorloven, omdat de afweging "doen of escaleren" de hele waarde van het patroon draagt.
Waar het misgaat. Bij rechten, niet bij taal. OWASP vat het risico samen als Excessive Agency: "the vulnerability that enables damaging actions to be performed in response to unexpected, ambiguous or manipulated outputs from an LLM", met drie oorzaken — te veel functionaliteit, te veel rechten en te veel autonomie (OWASP, LLM06:2025).
De aanbevolen maatregel is even saai als effectief: "human-in-the-loop control to require a human to approve high-impact actions before they are taken". Bepaal dus vooraf welke handeling een mens bevestigt, en test de agent eerst zonder schrijfrechten.
In onze eigen AI-business-assistent zit die grens in het product. De factuurherinneringen lopen automatisch via escalatietrappen op 0, 7, 14, 30 en 45 dagen, maar een agendablok dat een mens zelf heeft verplaatst wordt gelockt en daarna niet meer automatisch verzet.
Hoe zo'n agent technisch in elkaar zit en wanneer zelf bouwen loont, staat in AI-agent laten maken.
Voorspelling: het patroon waarvoor een taalmodel meestal de verkeerde keuze is
Voorspelling schat vraag, doorlooptijd of afwijking op basis van je eigen historie. Het vraagt minimaal twee jaar consistente historie in één systeem — de poort waarop de meeste trajecten stranden.
Het is ook het patroon waar de meeste verwarring zit, want "AI" betekent hier zelden een taalmodel. In ablatiestudies op drie populaire LLM-gebaseerde voorspellers bleek dat het verwijderen van de taalmodel-component, of het vervangen ervan door een simpele attentielaag, de prestaties niet verslechtert: "in most cases the results even improve" (Tan e.a., NeurIPS 2024).
Reken dus met een statistisch model en gebruik het taalmodel hooguit om de uitkomst uit te leggen. Data-analyse software met voorspellingen en anomaliedetectie kost €15.000 tot €30.000, tegen €7.500 tot €12.000 voor een dashboard zonder vooruitblik.
Het faalpunt. Een vloeiende lijn over te weinig jaren. Een voorspelling zonder domme basislijn ernaast — vorige week, vorig jaar, hetzelfde seizoen — is een grafiek, geen model.
Eerlijk over ons eigen bewijs. Dit is het patroon waarvan wij het minste in productie hebben. Wat in het huurdersportaal draait is anomaliedetectie: alerts bij een te lage betrouwbaarheid of een onwaarschijnlijke sprong in een meterreeks.
Dat is afwijkingen signaleren, geen vraagvoorspelling. Aanbieders halen die twee graag door elkaar; vraag er dus expliciet naar.
De evaluatieset per patroon: wat je meet en waarop
Dit is het deel dat in offertes ontbreekt en in productie het verschil maakt. Elk patroon meet iets anders, en de verkeerde maat geeft je vals vertrouwen.
| Patroon | Wat je meet | Waarop | Wanneer je stopt |
|---|---|---|---|
| Classificatie | Juist gerouteerd per klasse, apart voor de zeldzame klassen | Gelabelde set uit je eigen historie | Zodra de zeldzaamste klasse onder je drempel zakt |
| Extractie | Nauwkeurigheid per veld, niet per document | 30-50 van je moeilijkste documenten per leverancier | Bij ons: pas door bij 95%+ per veld |
| RAG | Of de juiste passage is opgehaald, vóór het antwoord | Vragen met een vooraf bekend brondocument | Als het ophalen de vraag mist, niet als het antwoord raar klinkt |
| Agent | Welke acties hij deed, niet wat hij zei | Droogloop op echte gevallen zonder schrijfrechten | Voordat je schrijfrechten aanzet |
| Voorspelling | Fout tegenover een domme basislijn | Historie die het model niet gezien heeft | Als de basislijn wint |
Een evaluatieset is geen document maar een bestand dat meedraait bij elke wijziging. Zonder die set merk je een modelwissel pas aan een klacht.
Leg ook het eigendom vast. Bij ons zijn de broncode, de prompts, de evaluatiesets en de documentatie vanaf dag één van de opdrachtgever — precies zodat een overstap naar een ander model of een andere partij geen herbouw is.
Wat het model kost, en waarom dat per patroon anders schaalt
De modelrekening is zelden de grootste post, maar hij schaalt per patroon compleet anders. Reken met de lijstprijzen per miljoen tokens van Anthropic: Claude Haiku 4.5 $1 in en $5 uit, Claude Sonnet 5 $2 in en $10 uit, Claude Opus 5 $5 in en $25 uit.
Vier verschillende schaalgedragingen, in één regel elk:
- Classificatie schaalt lineair met je volume: één korte vraag, één kort antwoord.
- Extractie schaalt met beeld; een foto van een meterkast kost meer invoertokens dan een pagina platte tekst.
- RAG schaalt met wat je ophaalt, niet met de vraag: de passages rijden elke keer mee als invoer.
- Agent schaalt met het aantal beurten, want elke beurt stuurt de hele historie opnieuw mee.
Die laatste is de post die structureel te laag wordt begroot. Tien beurten is niet tien keer één aanroep, het is de groeiende historie tien keer.
Zet je tellers daarom op de functie en niet op de applicatie. Alleen dan zie je welke van de vijf de rekening opdrijft, en kun je daar wisselen zonder de rest aan te raken.
Naast modelkosten loopt het beheer door: bij ons vanaf €750 per maand voor een ingebouwde AI-functie. En als je afweegt wat een bureau dat zelf met AI bouwt aan je project verandert, lees dan software laten ontwikkelen met AI.
Welk patroon je als eerste kiest
Kies niet op techniek maar op wat er vandaag door mensenhanden gaat:
- Documenten die iemand overtypt → extractie, en je weet binnen twee weken of het klopt.
- Een binnenkomende stroom die iemand sorteert → classificatie, met een drempel uit je eigen historie.
- Vragen waarvan het antwoord in je eigen documenten staat → RAG, gemeten op het ophalen.
- Een terugkerende handeling in een systeem → agent, maar pas nadat één van de drie hierboven draait.
- Vooruitkijken → voorspelling, en check eerst of je twee jaar consistente historie hebt.
Zit je AI-functie op een pakket dat je niet zelf in de hand hebt, dan verandert dat de route maar niet het patroon; die afweging staat in AI integreren in bestaande software.
Weet je welk patroon bij je past maar niet wat het in jouw situatie oplevert? Vraag de gratis AI-scan aan of plan een gesprek van 30 minuten; de bredere vormkeuze staat in de gids software met AI.
Opgesteld met AI-ondersteuning, geredigeerd en inhoudelijk verantwoord door Bram Dokman.