Kort antwoord
Een disaster recovery plan voor een MKB-bedrijf draait om twee getallen per systeem: de RTO, hoe snel het weer moet werken, en de RPO, hoeveel data je maximaal mag verliezen. Daarop richt je de back-ups in volgens 3-2-1: drie versies van je data op twee soorten media, waarvan één op een andere locatie en liefst één offline of onveranderbaar. De zes stappen zijn systemen inventariseren, per systeem RTO en RPO kiezen, back-ups automatiseren, herstelprocedures uitschrijven, communicatie en noodtoegang regelen en een eerste hersteltest inplannen, daarna minimaal twee per jaar.
Van lezen naar doen.
 Business Center Altena / HVS Trading (Henk Verhoeven)
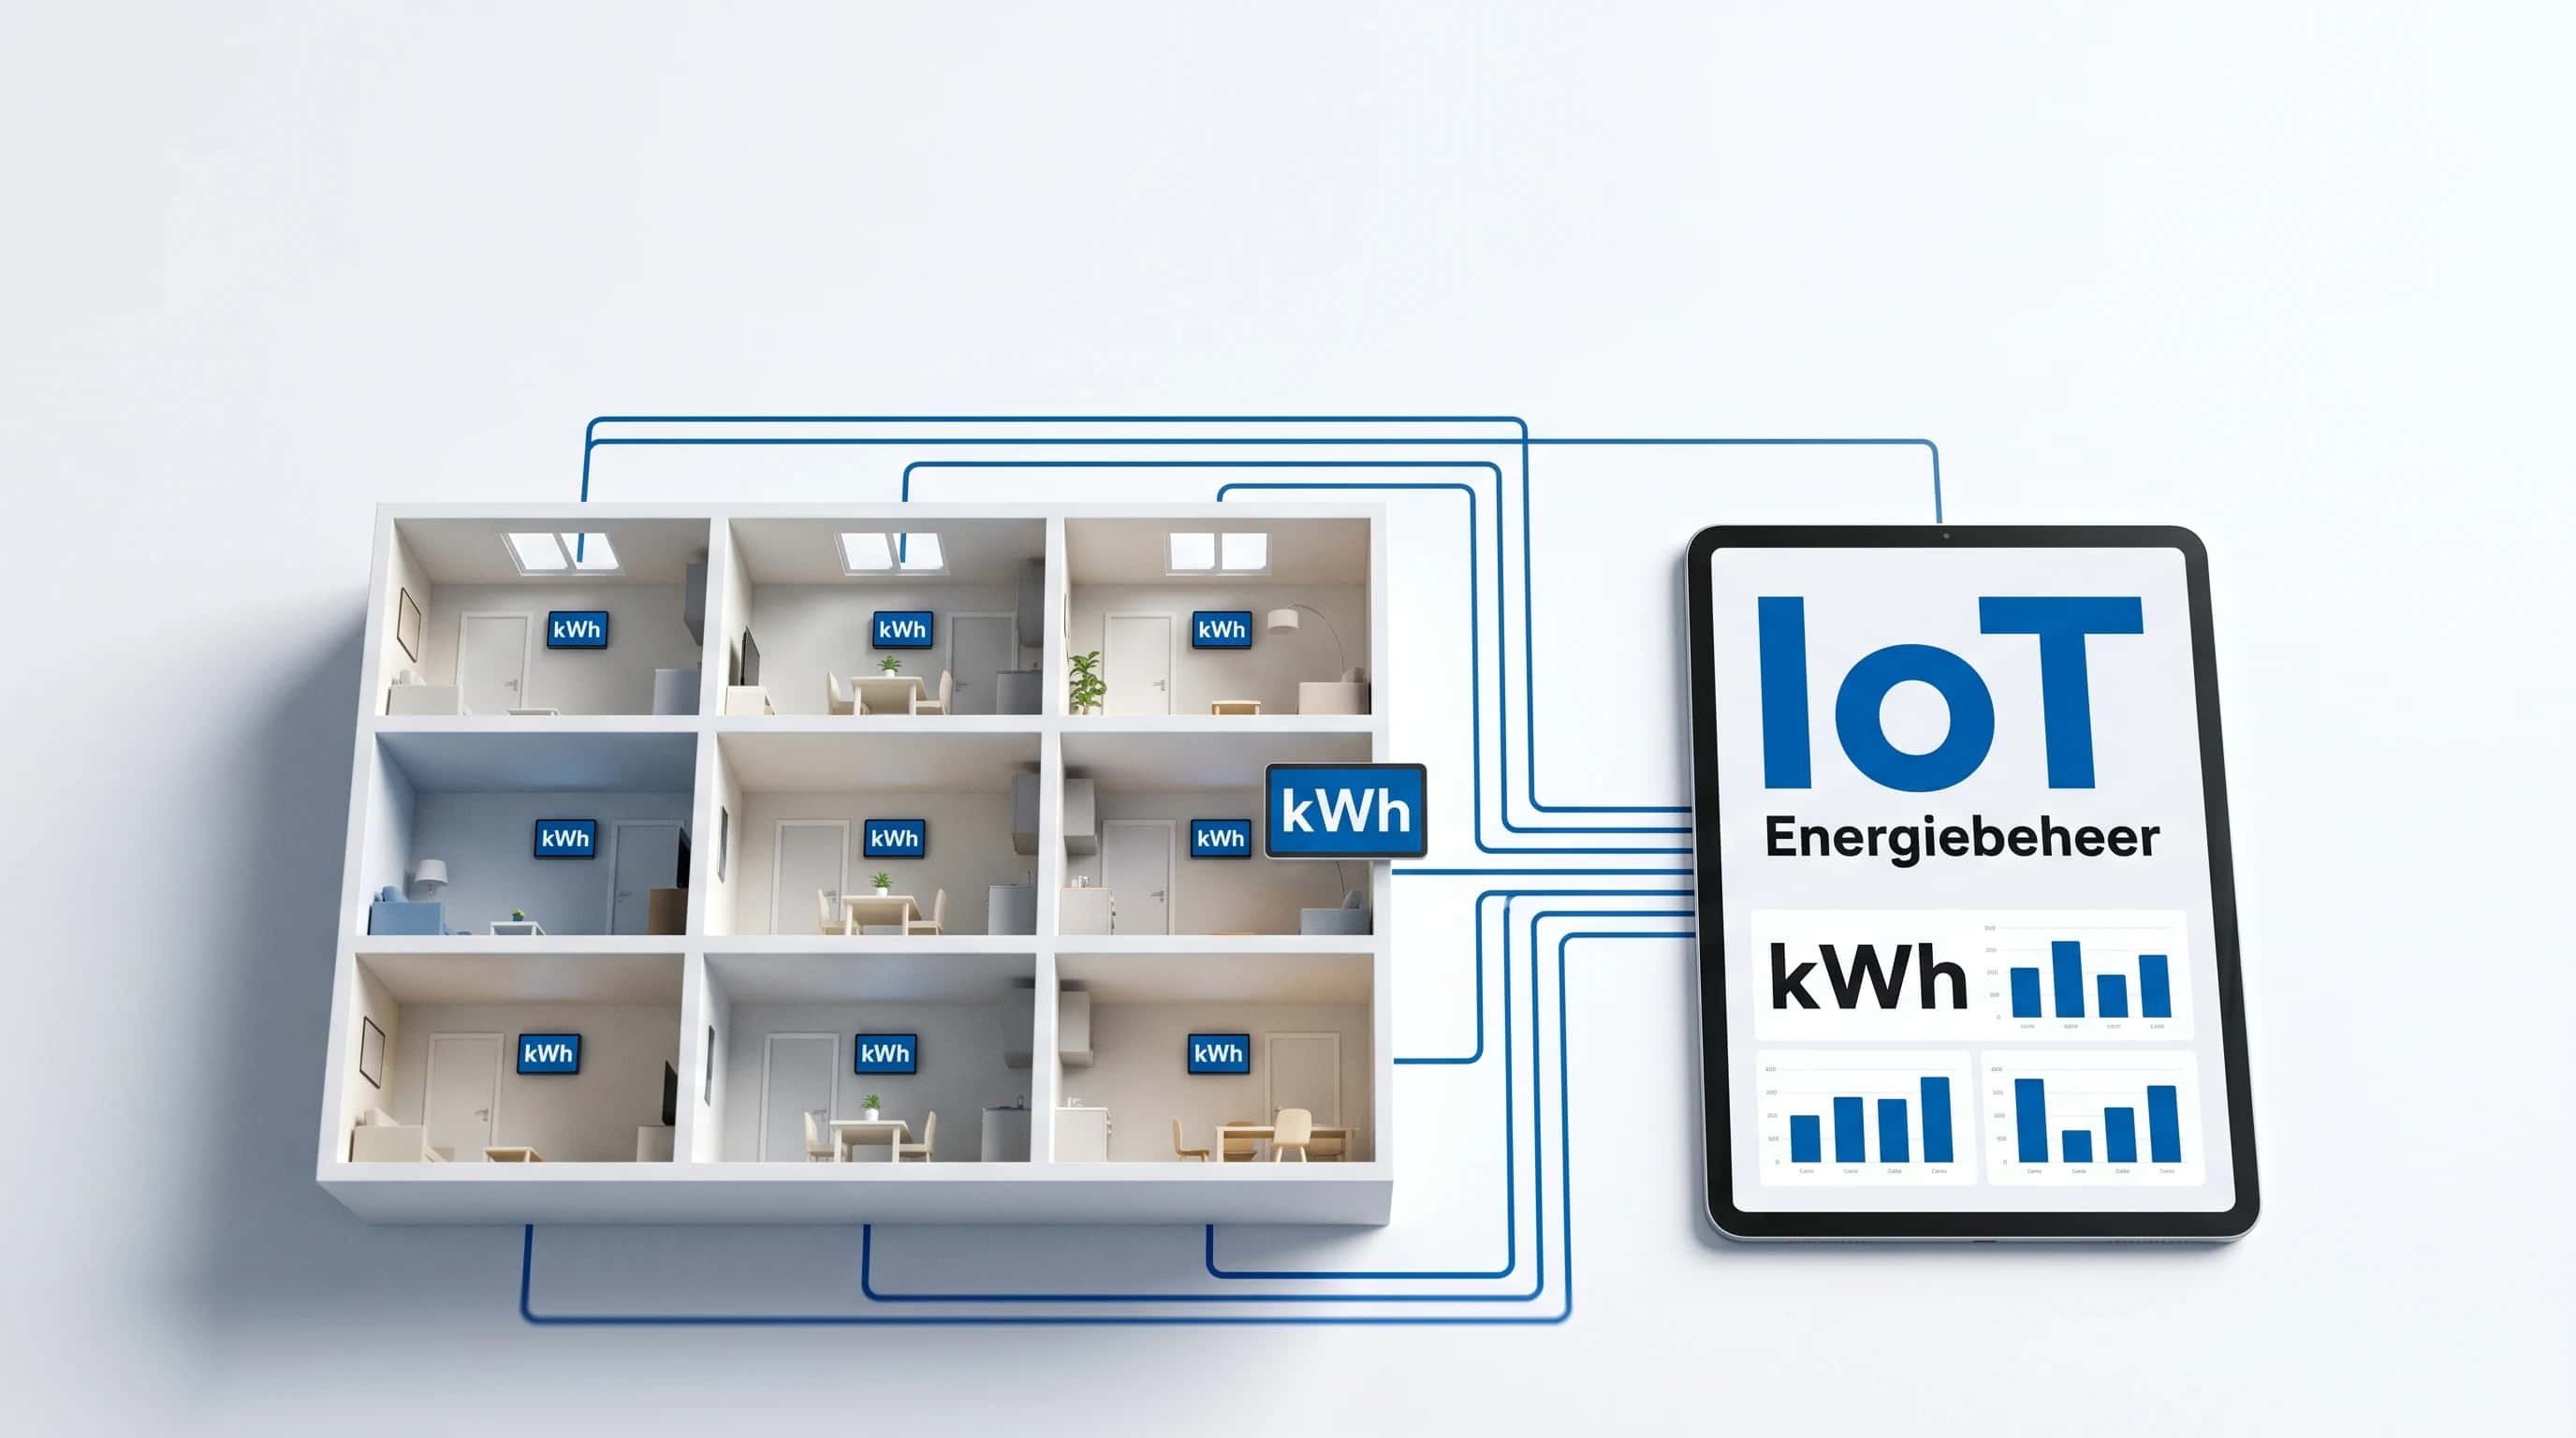
Multi-tenant Huurdersportaal met IoT-energiemonitoring
IoT + AIgeautomatiseerd meterstanden aflezen
Een disaster recovery plan voor het MKB legt per systeem vast hoe snel je na een IT-ramp weer draait (de RTO) en hoeveel data je daarbij mag verliezen (de RPO) — en wie welke herstelstap zet. De meeste MKB-bedrijven beantwoorden die vragen pas als de server al versleuteld is: ruim een derde van de Nederlandse microbedrijven maakt niet eens een back-up, blijkt uit de Cybersecuritymonitor 2024 van het CBS.
Sinds 15 augustus 2026 is de Cyberbeveiligingswet van kracht en is die voorbereiding voor ruim 8.000 Nederlandse organisaties bovendien een wettelijke zorgplicht — back-upbeheer en herstelplannen staan letterlijk in de wetstekst. Deze wegwijzer hoort bij de CleverTech AI-gids over maatwerk software en loopt de route af: RTO en RPO in gewone taal, de 3-2-1-strategie, cloud of on-premise, een invulbaar RTO/RPO-template met een uitgewerkt voorbeeld, zes stappen en het testritme dat het verschil maakt tussen een plan en hoop.
Wat is een disaster recovery plan en wat staat erin?
Een disaster recovery plan (DRP) is een gedocumenteerde procedure die beschrijft hoe je bedrijf IT-systemen en data herstelt na een calamiteit: ransomware, brand, waterschade, een gecrashte server of simpelweg een medewerker die de verkeerde map verwijdert. Het plan beantwoordt vier vragen: wat herstellen we eerst, hoe snel, met hoeveel dataverlies, en wie doet wat?
Het verschil met een back-up is het verschil tussen een reserveband en weten hoe je hem monteert — langs de snelweg, in de regen. Concreet bevat een bruikbaar DRP:
- een prioriteitenlijst van systemen en processen (niet alles hoeft tegelijk terug)
- per systeem een hersteltijd-doel (RTO) en een maximaal dataverlies (RPO)
- de back-upstrategie die daarbij hoort, inclusief locaties en frequenties
- herstelprocedures die iemand ánders dan je vaste IT-er kan uitvoeren
- een communicatieplan: wie informeert klanten, leveranciers en — bij een datalek — de Autoriteit Persoonsgegevens
Dat klinkt als veel papier.
Voor een gemiddeld MKB-bedrijf past de kern op vier tot zes kantjes. De waarde zit niet in de dikte, maar in de vraag of het document klopt én geoefend is.
Hoe groot is het risico op een IT-ramp voor het MKB?
Hoe waarschijnlijk is het eigenlijk dat jouw bedrijf dit overkomt? Wie die vraag googelt, vindt cijfers die op het eerste gezicht flink uiteenlopen.
Het Digital Trust Center stelt dat één op de vier mkb-bedrijven slachtoffer wordt van een cyberaanval — maar andere onderzoeken komen op heel andere percentages uit. Dat verschil verdient uitleg, want het bepaalt hoe je het risico moet lezen.
Waarom lopen de cijfers zo uiteen?
Onderzoek van De Haagse Hogeschool (via Platform Veilig Ondernemen, 2025) meet dat 12% van het mkb ooit door ransomware is getroffen, terwijl de Cybersecuritymonitor 2025 (CBS/NCSC) juist maar 4% bedrijven telt met minstens één incident door een aanval van buitenaf in 2024.
Spreken die bronnen elkaar tegen? Nee — ze meten verschillende dingen.
Het CBS telt incidenten per jaar, het DTC en de Haagse Hogeschool kijken naar de kans dat het je óóit overkomt, en alleen naar wat bedrijven zelf herkennen en rapporteren.
Voor de planning van je disaster recovery is de jaarkans sowieso de verkeerde maat. De relevante vraag is: wat gebeurt er met mijn bedrijf áls het gebeurt?
Een ransomware-aanval legt je systemen gemiddeld dagen tot weken plat, en brand of waterschade maakt geen onderscheid tussen server en back-upschijf in dezelfde kast.
De weerbaarheidskloof tussen klein en groot
Interessanter is de weerbaarheidskloof die uit dezelfde monitor blijkt: 86% van de grote bedrijven neemt tien of meer beveiligingsmaatregelen, tegenover 13% van de microbedrijven. Uit de Cybersecuritymonitor 2024 van het CBS blijkt dat 64% van de microbedrijven back-ups maakt, tegenover 97% van de grote bedrijven.
Aanvallers weten dat ook.
De cyberverzekering-paradox
En de cyberverzekering dan? Die voelt als de makkelijke oplossing, maar promotieonderzoek van politie-specialist Tom Meurs (NCSC, voorheen Digital Trust Center) laat het omgekeerde zien: verzekerde bedrijven betalen gemiddeld 2,8 keer méér losgeld, omdat criminelen hun eisen afstemmen op de dekking.
Hetzelfde onderzoek bevat het belangrijkste cijfer uit dit hele artikel: bedrijven met goed ingerichte back-ups betalen 27 keer minder vaak losgeld. Je back-up is dus geen administratieve verplichting — het is je onderhandelingspositie.
Wil je weten waar jouw grootste kwetsbaarheden zitten? Onze patch-management-gids laat zien waar de meeste MKB-bedrijven ze laten liggen.
Wat betekenen RTO en RPO en hoe kies je ze?
RTO en RPO zijn de twee getallen waar elk disaster recovery plan op rust. Ze dwingen je om vóóraf te beslissen wat uitval mag kosten, in plaats van dat tijdens de crisis te ontdekken.
Wat is RTO?
De Recovery Time Objective is de maximale tijd die mag verstrijken voordat een systeem weer werkt. Een RTO van vier uur betekent: vier uur na het incident draait het systeem weer, wat er ook gebeurd is.
Hoe korter de RTO, hoe duurder de oplossing — een uitwijkomgeving die binnen minuten overneemt kost een veelvoud van een back-up die je in een dag terugzet.
Wat is RPO?
De Recovery Point Objective is de maximale hoeveelheid data die je mag verliezen, uitgedrukt in tijd. Maak je elke nacht om 02:00 een back-up en crasht je systeem om 16:00, dan ben je veertien uur aan werk kwijt.
Je RPO bepaalt dus rechtstreeks je back-upfrequentie: een RPO van een kwartier vraagt om continue replicatie, een RPO van een dag om een nachtelijke back-up.
Het CleverTech AI-herstelkwadrant
De valkuil is om voor álles de strengste eisen te stellen — dan wordt disaster recovery onbetaalbaar. In de praktijk hanteren wij een kwadrant dat per proces de juiste oplossing aanwijst:
| RPO ruim (een dag dataverlies acceptabel) | RPO krap (minuten tot een uur) | |
|---|---|---|
| RTO ruim (dagen) | Profiel 1 — Basis: nachtelijke geautomatiseerde back-up. Denk aan: archief, documenten, website-content. | Profiel 3 — Datakritisch: continue databasereplicatie, herstel mag even duren. Denk aan: boekhouding, urenregistratie. |
| RTO krap (uren) | Profiel 2 — Sneldraaiend: image-based back-ups plus geoefende restore. Denk aan: werkplekken, kassasysteem. | Profiel 4 — Continu: uitwijkomgeving met failover. Denk aan: webshop-orders, zorgplanning, productie-aansturing. |
Prioriteringstabel: welke RTO en RPO horen bij welk systeem?
Het kwadrant vertaalt zich naar een vertrekpunt per systeemtype. De waarden hieronder zijn wat CleverTech AI als startpunt adviseert, geen marktnorm — je eigen stilstandskosten bepalen of je strenger of ruimer gaat zitten.
| Systeem | Criticaliteit | RTO (advies) | RPO (advies) | Profiel |
|---|---|---|---|---|
| ERP, orderverwerking of planning | Bedrijfskritisch | 4 uur | 15 minuten tot 1 uur | 4 |
| Kassa, webshop of facturatie | Bedrijfskritisch | 4 uur | 15 minuten | 4 |
| E-mail en agenda | Hoog | 1 werkdag | 1 uur | 3 |
| Boekhouding en urenregistratie | Hoog | 1 werkdag | 4 uur | 3 |
| Fileserver en documentenarchief | Midden | 1 tot 2 werkdagen | 1 dag | 1 |
| Marketingsite en nieuwsbrief | Laag | Enkele dagen | 1 dag | 1 |
Twee vuistregels bij het invullen. Een systeem waar mensen op staan te wachten krijgt een krappe RTO; een systeem waarin gegevens ontstaan die je niet kunt reconstrueren, krijgt een krappe RPO.
Een installatiebedrijf met twintig monteurs ontdekt zo bijvoorbeeld dat de werkbonnen-app in profiel 4 hoort (monteurs staan stil zonder), maar het documentenarchief prima in profiel 1 past. Die scherpte bespaart duizenden euro's per jaar aan overbodig zware oplossingen — en voorkomt dat het ene systeem dat écht kritisch is, onderbedeeld blijft.
Hoe werkt de 3-2-1-strategie in de praktijk?
De 3-2-1-regel is de norm die het NCSC — waarin het Digital Trust Center is opgegaan — aan alle Nederlandse bedrijven adviseert: bewaar drie versies van je data (het origineel plus twee back-ups), op twee verschillende soorten media, waarvan één op een andere locatie.
Voor een typisch MKB-bedrijf ziet dat er zo uit: de werkdata staat op de server of in een cloudapplicatie (versie 1), een NAS op kantoor maakt elke nacht automatisch een kopie (versie 2, medium één), en een cloud-back-updienst schrijft dagelijks een versleutelde kopie naar een Europees datacenter (versie 3, medium twee, andere locatie).
Brand in het pand? De cloudkopie leeft.
Ransomware in het netwerk? Dan wordt het spannender — en precies daarom is de regel aan het opschuiven.
Waarom 3-2-1-1-0 de nieuwe norm wordt
Moderne ransomware versleutelt niet alleen je werkdata, maar zoekt actief naar aangekoppelde back-ups om die eerst onbruikbaar te maken. Een NAS die als netwerkschijf aan het domein hangt, wordt daarbij net zo hard geraakt als de server zelf — de aanvaller weet dat een bedrijf zonder werkende back-up eerder betaalt.
Daarom breidt de vakwereld de regel uit naar 3-2-1-1-0: één extra kopie die offline of onveranderbaar (immutable) is, en nul fouten bij de hersteltest. Een back-up die de aanvaller kan bereiken, is geen back-up — het is een tweede slachtoffer.
Cloud of on-premise: waar bewaar je je back-ups?
De eerlijke vraag voor je disaster recovery is niet cloud óf on-premise, maar welke combinatie past bij jouw RTO, RPO en budget. Beide hebben een structureel sterk en een structureel zwak punt:
| Criterium | Cloud-back-up | On-premise (NAS/server) | Hybride (beide) |
|---|---|---|---|
| Bescherming bij brand/diefstal/water | Sterk — data staat elders | Zwak — zelfde pand, zelfde risico | Sterk |
| Herstelsnelheid grote datasets | Beperkt door internetverbinding | Snel — lokaal netwerk | Snel via lokaal, vangnet via cloud |
| Bescherming tegen ransomware | Goed, mits versiebeheer en immutability aan staan | Zwak als de NAS in het domein hangt | Goed, mits één kopie losgekoppeld is |
| Kostenmodel | Maandelijks abonnement per werkplek of GB | Eenmalige aanschaf plus beheer | Beide, maar gericht ingezet |
| AVG en datalocatie | Zelf opletten: kies een EU-datacenter | Volledige controle | Controle plus check op cloudleverancier |
Twee praktijklessen die in leveranciersbrochures zelden staan. Eén: de terugzet-snelheid van cloud-back-ups wordt begrensd door je internetverbinding — twee terabyte terughalen over een gemiddelde zakelijke glasvezellijn kost al snel een werkdag.
Wie een krappe RTO heeft, wil dus óók een lokale kopie.
Twee: een NAS die permanent als netwerkschijf gekoppeld is, wordt door ransomware gewoon meeversleuteld. De 3-2-1-opzet met een losgekoppelde of immutable kopie is geen luxe maar de kern van de bescherming.
Draai je je applicaties nog volledig op een eigen server in het pand, dan verkleint migreren naar de cloud de kwetsbaarheid voor brand, diefstal en waterschade structureel — de data en systemen staan dan immers niet meer op één fysieke locatie.
Is een Microsoft 365-back-up onderdeel van je herstelplan?
Microsoft houdt de dienst in de lucht, maar zet jouw verwijderde of versleutelde data niet terug in de tijd. Wat je ingebouwd krijgt is retentie met een houdbaarheidsdatum, en dat is iets anders dan een back-up.
| Wat er weg is | Hoe lang Microsoft het standaard bewaart |
|---|---|
| Definitief verwijderde mail (map Recoverable Items) | 14 dagen, maximaal 30 dagen instelbaar |
| Bestanden uit SharePoint, OneDrive en Teams | 93 dagen, verdeeld over de twee prullenbakken samen |
| De OneDrive van een vertrokken medewerker | 30 dagen, daarna 93 dagen in de prullenbak van de siteverzameling |
Drie dingen volgen daaruit.
Een besmetting die drie maanden onopgemerkt blijft valt buiten elk van deze vensters, en een bestand dat versleuteld is overschreven belandt niet in een prullenbak.
Microsoft verkoopt voor dat gat een aparte dienst: Microsoft 365 Backup draait op pay-as-you-go, kost $0,15 per GB per maand met gratis herstel, en heeft een terugzetvenster van drie maanden tot twee jaar (Microsoft Learn, geraadpleegd 15-09-2026).
En je gekoppelde pakketten tellen niet mee: een boekhoud- of CRM-applicatie die via een API in Microsoft 365 schrijft, valt onder de retentie van díé leverancier — vraag die per pakket op, zoals in stap 3 hieronder.
Wat kost disaster recovery voor een MKB-bedrijf?
Reken eerst de andere kant uit: wat kost stilstand? Tel de loonkosten van medewerkers die niet kunnen werken (aantal medewerkers maal uurtarief), de gemiste omzet per uur en eventuele contractuele boetes bij elkaar.
Voor een bedrijf met vijftien kantoormedewerkers lopen alleen de doorbetaalde loonkosten bij een dag uitval al richting de 3.000 tot 4.500 euro — omzetderving en herstelkosten komen daar bovenop. Maak die som per systeem: dat is meteen de onderbouwing voor de RTO-kolom verderop, en de businesscase voor een fatsoenlijke back-upinfrastructuur schrijft zichzelf.
De investering in disaster recovery schaalt mee met het kwadrantprofiel uit dit artikel. In de trajecten die CleverTech AI begeleidt zien we grofweg drie niveaus: een basisopzet (profiel 1-2: NAS plus cloud-back-up voor 10 tot 25 werkplekken) kost eenmalig enkele honderden euro's aan hardware plus enkele tientjes per maand aan cloudopslag.
Continue databasereplicatie (profiel 3) voegt vooral inrichtings- en beheerkosten toe. Een volwaardige uitwijkomgeving met failover (profiel 4) begint bij honderden euro's per maand en is alleen zinvol voor processen waar elk uur stilstand direct geld kost.
Goed om te weten: de subsidieregeling Mijn Cyberweerbare Zaak (RVO) is open van 7 september tot en met 30 november 2026. De regeling vergoedt 50% van de kosten tot maximaal 1.250 euro, voor ondernemingen met maximaal 50 werknemers en minder dan 10 miljoen euro omzet in het afgelopen boekjaar.
"Back-ups instellen en testen" staat met zoveel woorden in de lijst met subsidiabele maatregelen, inclusief een kant-en-klare NAS met schijven. Voorwaarden: minimaal 400 euro subsidiabele kosten, en de maatregel mag niet vóór 7 september 2026 zijn afgenomen of betaald.
Hoe stel je een disaster recovery plan op in zes stappen?
Stap 1: inventariseer je systemen en afhankelijkheden
Zet alle systemen op een rij waar je bedrijf op draait: boekhouding, CRM, e-mail, planning, webshop, machines met software-aansturing. Noteer per systeem waar de data staat en welk systeem van welk ander systeem afhankelijk is.
Wie zijn processen al eens in kaart bracht voor digitalisering van bedrijfsprocessen heeft hier een voorsprong — het is dezelfde oefening met een andere bril.
Stap 2: bepaal per systeem RTO en RPO
Gebruik het herstelkwadrant. Wees streng: niet alles is profiel 4.
De vraag die helpt: hoeveel uur mag dit systeem plat liggen voordat het écht pijn doet — niet ongemakkelijk is, maar pijn doet?
Leg het antwoord vast in vijf kolommen, één regel per systeem. Dat blad ís je RTO/RPO-plan; de rest van dit artikel vult het in.
| Systeem | Wat valt stil zonder | RTO | RPO | Profiel |
|---|---|---|---|---|
| jouw systeem | het proces dat stopt, en wie het als eerste merkt | uren of dagen | minuten, uren of een dag | 1-4 |
Ingevuld voorbeeld: een autoservicebedrijf
Een werkplaats maakt de afweging concreet, omdat er systemen in alle vier de profielen naast elkaar draaien. Onderstaande invulling is een rekenvoorbeeld voor een autoservicebedrijf met vier hefbruggen — geen klantcase, maar een uitgewerkt model dat je naast je eigen systeemlijst kunt leggen:
| Systeem | Wat valt stil zonder | RTO | RPO | Profiel |
|---|---|---|---|---|
| Werkplaatsplanning en werkorders | Monteurs zonder opdracht, klanten zonder afspraak | 4 uur | 1 uur | 4 |
| Kassa en facturatie | Auto's kunnen niet worden uitgegeven en afgerekend | 4 uur | 15 minuten | 4 |
| Onderdelenvoorraad en bestelkoppeling | Bestellen bij de groothandel, doorlooptijd per klus | 1 werkdag | 4 uur | 3 |
| Voertuig- en onderhoudshistorie | Aantonen welk onderhoud is uitgevoerd, richting klant en importeur | 1 werkdag | 1 uur | 3 |
| Urenregistratie monteurs | Loonverwerking en nacalculatie | 2 werkdagen | 1 dag | 1 |
| Kantoorbestanden en e-mail | Administratie en correspondentie | 1 werkdag | 1 dag | 1 |
Drie dingen vallen op aan die verdeling. Planning en kassa staan hoger dan veel eigenaren vooraf inschatten: zonder werkorders staan de monteurs stil, en die uren tellen door in de stilstandskosten die je hierboven uitrekende.
De voertuighistorie heeft juist een ruime RTO maar een krappe RPO — een dag wachten mag, een verdwenen onderhoudsregel niet. En de twee onderste regels hoeven níét in de dure categorie, wat de rekening betaalbaar houdt.
Hetzelfde stramien werkt in elke sector waar een planning het werk aanstuurt. Bij software voor autobedrijven, installateurs en productiebedrijven is de planningssoftware doorgaans het systeem met het hoogste profiel — en het documentenarchief het laagste.
Stap 3: richt je back-ups in volgens 3-2-1
Automatiseer alles. Een back-up die op een handmatige handeling wacht, wordt vergeten — niet soms, maar structureel.
Controleer ook wat er ín de back-up zit: cloudapplicaties zoals je boekhoudpakket of CRM vallen vaak búiten je eigen back-up en verdienen een aparte check bij de leverancier.
Stap 4: schrijf herstelprocedures die iedereen kan volgen
Documenteer per systeem: waar staat de back-up, welke stappen zet je, hoelang duurt het, en wie is verantwoordelijk. Test de procedure op leesbaarheid: kan een collega zonder IT-achtergrond hem volgen als jouw vaste IT-er op vakantie is?
Bewaar een papieren exemplaar — een herstelplan dat alleen op de versleutelde server staat, is een grap die niemand kan waarderen.
Stap 5: regel de communicatie en noodtoegang
Leg vast wie klanten en leveranciers informeert, wie de melding bij de Autoriteit Persoonsgegevens doet bij een datalek, en waar wachtwoorden en licentiecodes veilig maar bereikbaar liggen (een wachtwoordkluis met offline noodprocedure). Val je onder de Cyberbeveiligingswet, benoem dan ook een meldverantwoordelijke naast de technische herstelrol — waarom dat twee verschillende mensen moeten zijn, staat verderop.
Stap 6: plan de eerste hersteltest in
Een disaster recovery plan zonder testdatum is een voornemen. Zet de eerste test binnen een maand na oplevering in de agenda — en lees de volgende sectie voordat je denkt dat dit overdreven is.
Hoe test je of je disaster recovery echt werkt?
Zonder test weet je niet of je herstel werkt — je hoopt het. Of je back-up het doet, weet je pas op het moment dat corrigeren niet meer kan.
In de praktijk komen mislukte hersteltests bijna altijd door hetzelfde rijtje: de back-up draaide al maanden niet (niemand las de foutmails), er ontbrak een systeem in de back-upselectie, of het terugzetten duurde drie dagen waar vier uur was beloofd.
CleverTech AI adviseert minimaal twee hersteltests per jaar, in de agenda, met dezelfde vanzelfsprekendheid als een brandoefening. Meet bij elke test drie dingen:
- Restore-tijd versus RTO — haal je de hersteltijd die in je plan staat, inclusief het uitpakken, terugzetten en controleren?
- Volledigheid — open de teruggezette bestanden en applicaties echt; een back-up die terugzet maar corrupt blijkt, telt niet
- Uitvoerbaarheid — laat de test minstens één keer per jaar uitvoeren door iemand anders dan degene die de back-ups heeft ingericht
Wie deze drie metingen een paar keer heeft gedaan, weet meer over zijn continuïteit dan welk aangeschaft product ook kan beloven.
Wat de Cyberbeveiligingswet sinds 15 augustus 2026 van je herstelplan vraagt
Sinds de Cyberbeveiligingswet op 15 augustus 2026 in werking trad is bedrijfscontinuïteit geen goed voornemen meer maar een zorgplicht. Maatregel 3, "voorbereiding op uitval", verwijst naar artikel 21 lid 3 sub c Cbw en noemt letterlijk "bedrijfscontinuïteit, zoals back-upbeheer en herstelplannen, en crisisbeheer" (NCSC, zorgplicht Cbw).
De meldklok loopt terwijl je herstelt
Het detail dat in de meeste herstelplannen ontbreekt: de meldplicht loopt gelijk op met je herstel. Binnen 24 uur een vroegtijdige waarschuwing via MijnNCSC, binnen 72 uur een volledige melding met een eerste ernstinschatting, en binnen een maand een eindverslag met oorzaak en genomen maatregelen.
Dat heeft twee gevolgen voor je DRP. Eén: de meldverantwoordelijke uit stap 5 is een andere persoon dan wie de server terugzet — die twee taken vallen in hetzelfde tijdvenster en niemand doet ze allebei goed.
Twee: dat eindverslag valt of staat met logging die het incident reconstrueert, dus bewaar logbestanden buiten het getroffen systeem. Ransomware die je logs meeversleutelt, neemt je bewijsmateriaal mee.
Val je er niet onder, dan komt de wet via je klanten binnen
De wet richt zich op essentiële en belangrijke sectoren zoals energie, zorg, transport en digitale infrastructuur. Organisaties die er wél onder vallen moeten hun toeleveringsketen aantoonbaar beheersen (maatregel 4) en zetten back-up- en hersteleisen door in hun inkoopvoorwaarden.
Onze verwachting: een aantoonbaar getest herstelplan wordt in 2027 voor steeds meer MKB-toeleveranciers gewoon een contractvoorwaarde, al verschilt het tempo per sector. Hoe die ketenwerking verder uitpakt — inclusief de boetes voor entiteiten die er rechtstreeks onder vallen — staat in onze gids over patch management voor het MKB.
Welke rol spelen maatwerk software en AI in je herstelplan?
Standaardsoftware heeft standaard-back-upopties, maar eigen applicaties vragen om herstel dat is méégebouwd. Bij de maatwerk software die CleverTech AI ontwikkelt, is disaster recovery daarom een ontwerpeis en geen bijlage: geautomatiseerde database-back-ups met versiebeheer, infrastructuur die als code is vastgelegd zodat een omgeving reproduceerbaar opnieuw op te bouwen is, en een gedocumenteerde restore-procedure als onderdeel van de oplevering.
Vraag daar ook naar bij je huidige leverancier — wie bedrijfssoftware op maat laat bouwen zonder herstelafspraken, koopt een systeem met een gat erin.
Voor AI geldt hetzelfde, met een extra laag: hoe meer processen op AI-software en automatisering draaien, hoe afhankelijker je wordt van de data waarop die automatisering rust. Prompts, configuraties, gekoppelde databronnen en workflow-definities horen net zo goed in je back-upselectie als je boekhouding.
Een geautomatiseerd proces dat na een incident niet te reconstrueren is, valt terug op handwerk dat niemand meer paraat heeft.
Van back-up naar geoefende routine
De volgorde van dit artikel is de volgorde van het werk: eerst weten wat kritisch is, dan RTO en RPO kiezen, dan pas techniek inrichten — en daarna vooral testen, twee keer per jaar, zonder uitzondering. Begin deze week met stap 1: de systeeminventarisatie kost een middag en legt meteen bloot waar het grootste gat zit.
Wil je sparren over de plek van disaster recovery in je bredere software-omgeving? De gids over maatwerk software behandelt het volledige traject van idee tot beheer.
Liever direct een paar ogen op jouw situatie? Plan een vrijblijvend gesprek — dan lopen we het herstelkwadrant samen door voor jouw systemen.
Opgesteld met AI-ondersteuning, geredigeerd en inhoudelijk verantwoord door het Redactieteam CleverTech AI.