Van lezen naar doen.
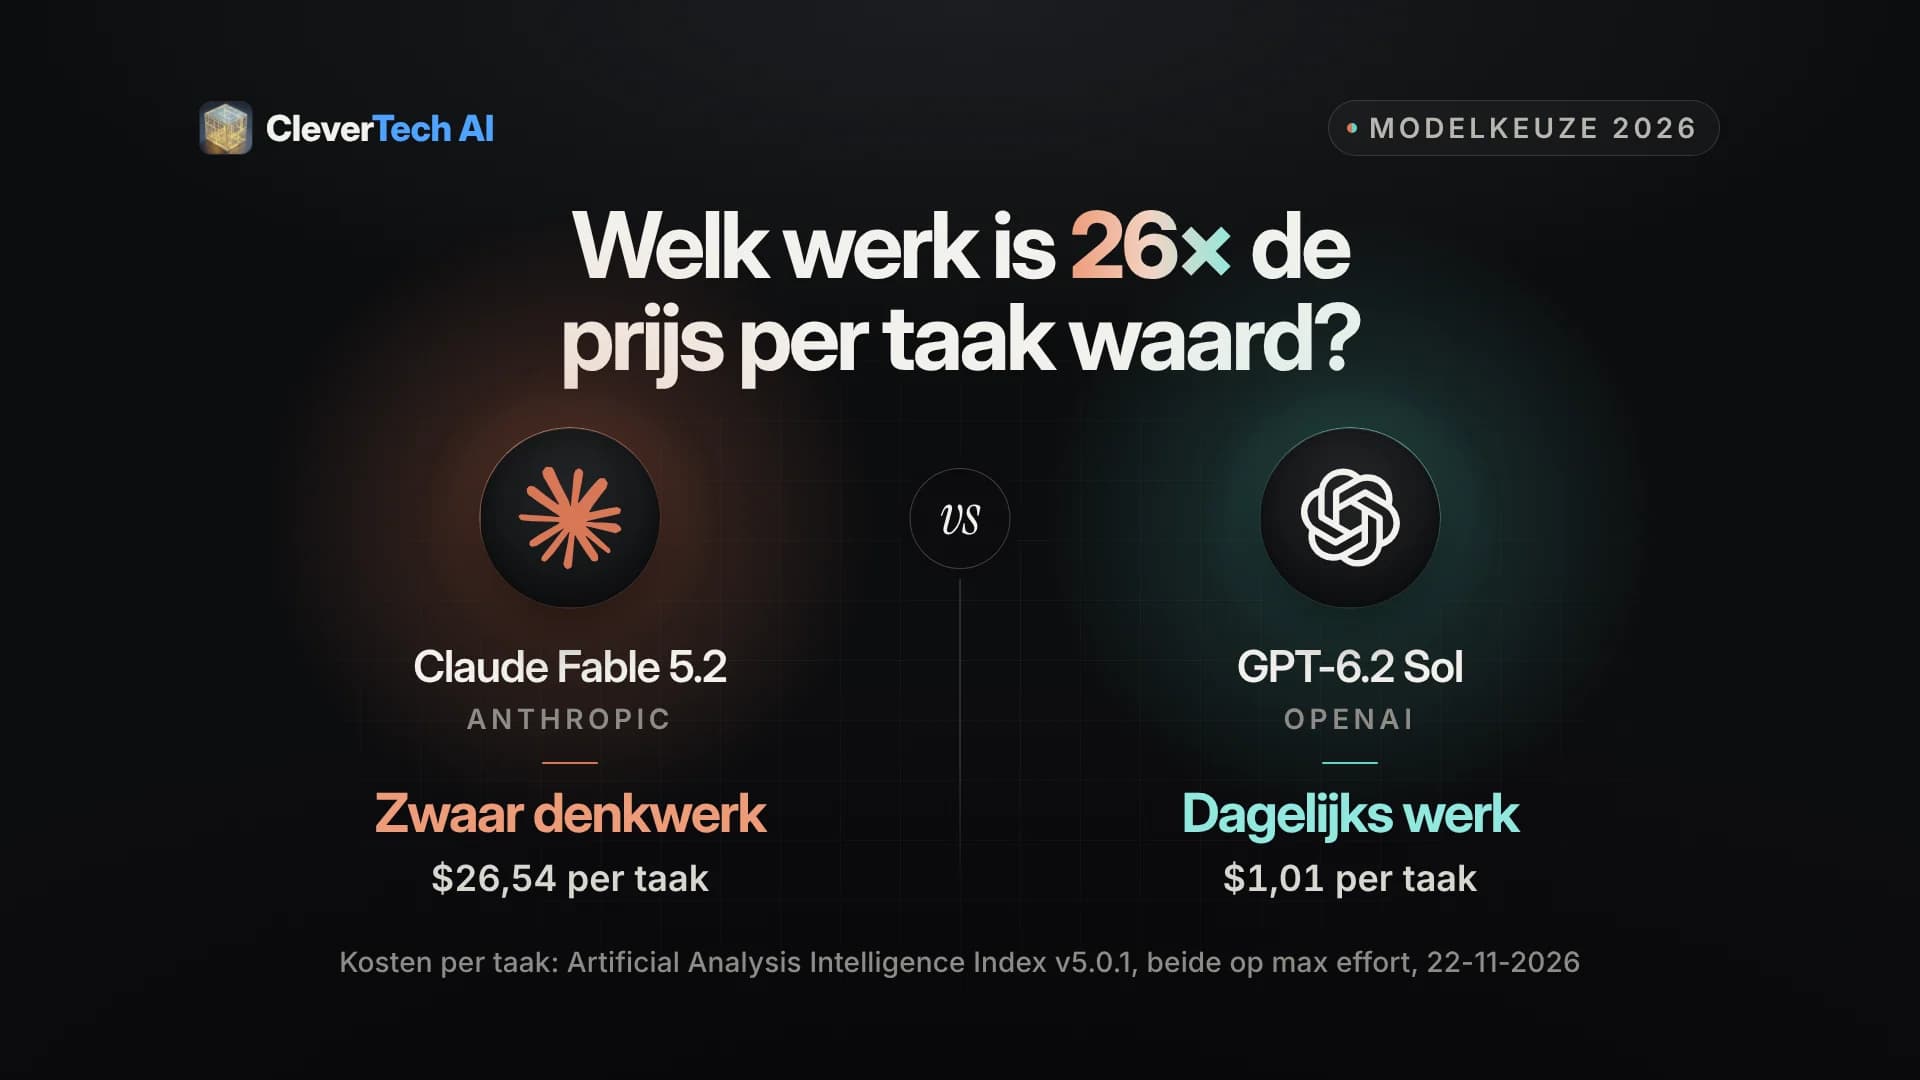
Eén taak, twee rekeningen: $26,54 of $1,01.
Dat kost één taak uit de Intelligence Index van Artificial Analysis met Claude Fable 5.2 en met GPT-6.2 Sol, allebei op max effort (Fable 5.2, GPT-6.2 Sol, stand 22 november 2026).
Fable scoort daar 65 punten (index v5.0.1, met Anthropics standaard-fallback aan), de hoogste score van de 95 gemeten modellen. Sol scoort 57.
Acht punten voor ruim 25 dollar extra per taak.
Of dat veel is, hangt af van de taak, en daarom gaat deze pagina niet over wie er wint. Ze gaat over welk werk bij welk model hoort en wat het daar kost.
De andere modellen, van Gemini tot Mistral, staan in het overzicht AI-modellen vergelijken.
Twee klassen, geen gelijk paar
Fable 5.2 en Sol zijn geen concurrenten in dezelfde prijsklasse, en dat zeggen de makers zelf.
Anthropic bracht Fable 5.2 op 9 november 2026 uit "for demanding reasoning and long-horizon agentic work" (modelpagina). In dezelfde aankondiging raadt Anthropic aan om voor de meeste code- en kennistaken te beginnen met Claude Opus 5.5.
OpenAI bracht GPT-6.2 Sol op 17 november 2026 uit en noemt het "our go-to model for everyday work, from coding to powering agents at scale" (modelpagina). Het topmodel van OpenAI is GPT-6.2 Astra, dat op dezelfde dag verscheen.
| Claude Fable 5.2 | GPT-6.2 Sol | |
|---|---|---|
| Uitgebracht | 9 november 2026 | 17 november 2026 |
| Model-ID | claude-fable-5-2 | gpt-6.2-sol |
| Rol volgens de maker | zwaar redeneerwerk, agentsessies van uren | dagelijks werk, van code tot agents op schaal |
| Input / output per miljoen tokens | $8 / $40 | $2 / $10 |
| Batch (input / output) | $4 / $20 | $1 / $5 |
| Cache read per miljoen tokens | $0,20 | $0,10 |
| Contextvenster | 1.000.000 tokens | 1.050.000 tokens (input max 922.000) |
| Maximale output | 128.000 tokens | 128.000 tokens |
| Toeslag lange context | geen | boven 272.000 input-tokens: hele verzoek 2× input, 1,5× output |
| Kennis-cutoff | juni 2026 | 1 juni 2026 |
| Gelijke klasse bij de ander | GPT-6.2 Astra ($8 / $40) | Claude Opus 5.5 ($4 / $20) |
Bronnen: Anthropic prijspagina en modelpagina, OpenAI pricing en modelpagina; peildatum 22 november 2026. Dollars zoals gepubliceerd, exclusief btw.
Valt je de laatste rij op? Fable 5.2 en GPT-6.2 Astra hebben exact dezelfde tokenprijs.
Wie topmodel tegen topmodel wil leggen, vindt die afweging, met de EU-route als beslissend punt, in Claude Fable vs GPT-6 Astra zakelijk. Die vergelijking gaat nog over de vorige generatie (Fable 5.1 tegen GPT-6 Astra); de afweging over dataresidentie geldt onverminderd.
Waarom dan toch Fable tegen Sol? Omdat dit de keuze is die in het MKB het vaakst speelt: één duur model voor alles, één goedkoop model voor alles, of een verdeling.
Veel teams hebben Claude én ChatGPT in huis. De vraag is waar je welk werk neerlegt.
Wat een taak kost: onze rekentabel
Een tokenprijs zegt weinig zolang je niet weet hoeveel tokens een taak gebruikt. Daarom rekenen we vijf gewone MKB-taken door.
Onze aannames, zodat je ze kunt vervangen door je eigen cijfers:
- Input per taak is onze schatting (mail plus instructies, document, dossier) en gelijk voor beide modellen.
- Output van Sol is onze schatting op effort medium, inclusief het denkwerk dat als output wordt afgerekend.
- Output van Fable is 2,8 keer die van Sol. Dat is de verhouding die Artificial Analysis op medium mat (22 november 2026): 41 miljoen tegen 14,6 miljoen outputtokens voor dezelfde indextaken.
- Bulkwerk loopt via de Batch API, de rest tegen standaardtarief, zonder cache.
| Taak (onze aanname per taak) | GPT-6.2 Sol | Claude Fable 5.2 | Factor |
|---|---|---|---|
| Klantmail beantwoorden: 3.000 tokens in, 800 uit | $0,014 | $0,11 | 8,1× |
| Factuur of order uitlezen via Batch: 2.000 in, 400 uit | $0,004 | $0,03 | 7,6× |
| Offerte of verslag uit notities: 8.000 in, 3.000 uit | $0,046 | $0,40 | 8,7× |
| Contract van zestig pagina’s doorlichten: 45.000 in, 5.000 uit | $0,14 | $0,92 | 6,6× |
| Dossier van 300.000 tokens in één verzoek, 10.000 uit | $1,35 | $3,52 | 2,6× |
| Indextaak van Artificial Analysis op max effort (gemeten) | $1,01 | $26,54 | 26,3× |
De Fable-kolom rekent met 2,8 keer de Sol-output uit de tweede kolom; de laatste rij is een meting, geen schatting. Sol rekent in de dossier-rij het lange-contexttarief van $4 / $15, omdat het verzoek boven 272.000 input-tokens komt.
Per maand ziet dat er zo uit:
| Volume per maand | GPT-6.2 Sol | Claude Fable 5.2 |
|---|---|---|
| 1.000 klantmails | $14 | $114 |
| 10.000 facturen of orders (Batch) | $40 | $304 |
| 200 offertes of verslagen | $9,20 | $80 |
| 50 contracten | $7 | $46 |
Drie dingen vallen op.
Hoe meer het model schrijft, hoe groter het gat. Per token is Fable vier keer zo duur; omdat het ook bijna drie keer zoveel schrijft, wordt dat per taak al snel acht keer. Bij een groot dossier dat vooral gelezen moet worden, krimpt het verschil tot 2,6 keer: Fable rekent geen toeslag voor lange context, Sol boven 272.000 tokens wel.
Op één taak is het verschil klein, op volume niet. Vijftig contracten per maand met Fable kosten $39 meer dan met Sol.
Kost één gemist punt in één contract meer dan dat, dan gaat de keuze over kwaliteit, niet over prijs. Bij duizend klantmails is $100 per maand weggegooid geld als Sol het goed doet.
De standaardstand van Fable maakt de som duurder. Op de API staat Fable 5.2 standaard op high. Artificial Analysis telde op high 85,3 miljoen outputtokens tegen 41 miljoen op medium (22 november 2026).
Laat je de standaard staan, dan verdubbelt het outputdeel van de Fable-kolom ongeveer: een klantmail wordt zo’n 1,85 keer zo duur, het dossier 1,3 keer.
Wil je deze som met je eigen tokens maken: in AI API-kosten berekenen staat hoe je tokens per taak meet, en op wat de Claude API kost alle Anthropic-tarieven op een rij.
Onze routingtabel: welk werk waarheen
Dit is de verdeling waarmee wij beginnen als een klant beide modellen tot zijn beschikking heeft. Het is een startpunt, geen eindoordeel: na een test met eigen voorbeelden schuift er vaak een rij.
| Werk | Leg het bij | Start-effort | Waarom |
|---|---|---|---|
| Klantvragen, chat en mail | GPT-6.2 Sol | medium | 8× goedkoper in onze som; Artificial Analysis mat op medium 3,6 tegen 6,6 minuten per indextaak |
| Facturen, orders en formulieren uitlezen in bulk | GPT-6.2 Sol via Batch | low of medium | Batch halveert de prijs; Flex bestaat niet meer voor de 6.2-modellen |
| Offertes, samenvattingen, verslagen | GPT-6.2 Sol | medium | het werk is controleerbaar en het volume telt |
| Dagelijkse code en kleine wijzigingen | GPT-6.2 Sol | medium | standaard in Codex sinds CLI 0.171.0; test wel op je eigen repo (zie hieronder) |
| Contract, dossier of beleidsstuk waar een gemist punt geld kost | Claude Fable 5.2, of eerst Opus 5.5 | high | 1 miljoen tokens zonder toeslag; Anthropic raadt Opus 5.5 als start aan |
| Onderzoek in meerdere stappen tot een af rapport, spreadsheet of deck | Claude Fable 5.2 | high | precies het werk waarvoor Anthropic het model positioneert |
| Agentsessies van uren: migratie, grote refactor | Claude Fable 5.2 | high, xhigh alleen bij gemeten winst | bij Artificial Analysis op high en xhigh dezelfde indexscore (62), xhigh schrijft ruim anderhalf keer zoveel |
| Beveiligingsonderzoek en kwetsbaarheden | geen van beide zonder meer | n.v.t. | Fable 5.2 blokkeert de meeste cybersecuritytaken; ook de 6.2-modellen van OpenAI hebben strengere safeguards |
| Feitenvragen zonder bron erbij | geen van beide zonder bron | n.v.t. | geef het model de bron mee; Artificial Analysis mat bij Sol op max een hallucinatiegraad van 55% |
AA-cijfers in deze tabel: Artificial Analysis, Intelligence Index v5.0.1, peildatum 22 november 2026.
Een paar rijen vragen uitleg.
Code. OpenAI maakte Sol de standaardkeuze in Codex (CLI 0.171.0, 20 november 2026). Tegelijk meet Artificial Analysis bij GPT-6.2 Sol 3 punten minder dan bij GPT-6.1 Sol op de Coding Agent Index (Codex-harness, max effort, stand 22 november 2026).
Voor dagelijkse code blijft Sol logisch, maar draai de wissel van 6.1 naar 6.2 niet blind door.
Contracten en dossiers. Hier ligt de echte afweging, en de goedkopere tussenstap is Opus 5.5 ($4 / $20, de helft van Fable per token). Anthropic zegt zelf: begin daar, en ga pas naar Fable 5.2 als je tests op Opus tekortschieten.
Die volgorde volgen wij ook. Hoe de Claude-trap verder loopt, van Haiku tot Fable, staat in Claude Haiku, Sonnet, Opus of Fable.
Beveiliging. Anthropic schrijft dat de safeguards van Fable 5.2 "block most cybersecurity-related tasks"; daarvoor is het zustermodel Mythos 5.2, alleen voor geverifieerde organisaties. OpenAI meldt dat de strengere safeguards van GPT-6.2 ook legitiem kwetsbaarheidsonderzoek beperken.
Voor pentest- of code-auditwerk is geen van beide de vanzelfsprekende keuze.
Wil je weten of je beter bij één leverancier blijft of twee modellen naast elkaar zet, met de verborgen kosten van zo'n opstelling: dat staat in één of meerdere AI-modellen. Binnen OpenAI zelf, van Luna tot Astra, helpt welk OpenAI-model kies je.
Welke effort-stand, per model
Artificial Analysis meet beide modellen van low tot max, maar elke leverancier bepaalt zelf wat een stand doet. Vergelijk daarom per stand, nooit een Fable-score op max met een Sol-score op medium zonder dat erbij te zeggen.
| Effort | Fable 5.2: index | Fable 5.2: outputtokens | Fable 5.2: tijd per taak | GPT-6.2 Sol: index | GPT-6.2 Sol: outputtokens | GPT-6.2 Sol: tijd per taak |
|---|---|---|---|---|---|---|
| max | 65 | 275 mln | 42,1 min | 57 | 60,9 mln | 10,1 min |
| xhigh | 62 | 144 mln | 24,5 min | 56 | ||
| high | 62 | 85,3 mln | 14,8 min | 55 | ||
| medium | 56 | 41 mln | 6,6 min | 53 | 14,6 mln | 3,6 min |
| low | 54 | 34,9 mln | 5,6 min | 41 |
Bron: Artificial Analysis, Intelligence Index v5.0.1, modelpagina’s van Fable 5.2 en GPT-6.2 Sol, peildatum 22 november 2026.
Lege cellen: niet door ons uitgelezen. Fable 5.2 draaide bij AA met Anthropics standaard-fallback aan.
Wat wij eruit halen:
- Fable op high is het kantelpunt. Dezelfde score als xhigh (62), met 41% minder outputtokens. Max geeft er 3 punten bij voor ruim drie keer de tokens van high.
- Sol op medium is de werkstand. 53 punten in 3,6 minuten per taak; max geeft 4 punten extra voor bijna drie keer de tijd.
- Fable op medium ligt dicht bij Sol op max. 56 tegen 57. Alleen al aan outputtokens kost Fable op medium dan nog zo'n 2,7 keer zoveel (41 miljoen × $40 tegen 60,9 miljoen × $10, eigen berekening).
- Fable op low zakt nauwelijks. 54 punten, terwijl Sol op low terugvalt naar 41. Wie Sol goedkoper wil laten draaien, gaat niet onder medium.
In de Claude-apps en Claude Code staat Fable 5.2 standaard op medium; op de API op high. Anthropic adviseert op de API bij high te beginnen, xhigh alleen te gebruiken voor het zwaarste lange code- en agentwerk waar je winst gemeten hebt, en max alleen om het plafond te meten.
Wat een indexscore wel en niet zegt, leggen we uit in AI-benchmarks lezen.
Wat de makers beweren, en wat Artificial Analysis mat
Leveranciers kiezen hun eigen benchmarks en vergelijken vaak met een ouder model van de concurrent. Daarom zetten we per punt de claim en de onafhankelijke meting apart onder elkaar, nooit in één cijfer.
Snelheid van Fable 5.2.
- Anthropic: volgens testers "up to 30% faster" dan Fable 5.1.
- Artificial Analysis: 108 tegen 90 tokens per seconde op max effort (22 november 2026).
Prijs van Fable 5.2.
- Anthropic: alle tokenposten 20% lager dan bij Fable 5.1 ($8 / $40 tegen $10 / $50).
- Artificial Analysis: per indextaak op max $26,54 tegen $12,99 bij Fable 5.1 (22 november 2026), omdat 5.2 veel meer schrijft (275 tegen 163 miljoen outputtokens).
Zuinigheid van GPT-6.2 Sol.
- OpenAI: betere resultaten "with fewer output tokens", voor dezelfde prijs als GPT-6.1 Sol.
- Artificial Analysis: 60,9 tegen 63,7 miljoen outputtokens op max, $1,01 tegen $1,27 per taak, en een score van 57 tegen 55 (max) en 53 tegen 46 (medium), stand 22 november 2026.
Een rechtstreekse vergelijking van de makers bestaat niet. In Anthropics benchmarktabel staat geen enkel GPT-6.2-model; OpenAI's release kwam acht dagen later. De vergelijkingen met Fable 5.2 in OpenAI's aankondiging gaan vooral over Astra, niet over Sol.
In de chat: welk abonnement geeft je welk model
Gebruik je de modellen niet via de API maar in de chat, dan beslist je abonnement.
| Claude Fable 5.2 (Claude) | GPT-6.2 Sol (ChatGPT) | |
|---|---|---|
| Gratis | nee | niet bevestigd |
| Instapabonnement | Pro ($20 per maand, $17 bij jaarbetaling): alleen via usage credits | Plus ($20): in Work en Codex |
| Zwaar gebruik | Max ($100): tot de helft van je weeklimiet | Pro: in Work en Codex |
| Team | alleen premium seat ($125 bij maandbetaling, $100 bij jaarbetaling): 50% van de weeklimieten; standard seat ($25 / $20) zonder Fable | Business ($25 bij maandbetaling, $20 bij jaarbetaling per gebruiker): in Work en Codex |
| Enterprise | ja | ja, nadat de beheerder het model aanzet |
Bronnen: claude.com/pricing en OpenAI over GPT-6.2 Astra en Sol en de ChatGPT-plannen, peildatum 22 november 2026.
Twee details maken het verschil.
Nieuwe Work-chats starten met Sol op de stand Light in de consumentenplannen en op Medium in Enterprise-workspaces. En dat Sol in de gewone Chat zit, naast Work, bevestigt OpenAI nergens.
Voor een team betekent dit: Fable 5.2 kost op Claude Team een premium seat, vijf keer de prijs van een standard seat. Geef die stoel aan de één of twee mensen die echt zwaar analysewerk doen, niet aan iedereen.
De bredere afweging per stoel staat in wat kost een zakelijk AI-abonnement, de limieten per Claude-plan in wat Claude kost.
Persoonsgegevens: welke route loopt via de EU
Werk je met klant- of personeelsgegevens, dan beslist de route vaak vóór het model.
| Route | Claude Fable 5.2 | GPT-6.2 Sol |
|---|---|---|
| Eigen API van de maker | geen EU-optie: inference_geo kent alleen global en us |
EU-dataresidentie (EER en Zwitserland), na goedkeuring door sales, +10% |
| Grote cloud | Google Cloud (Google managed), multi-region eu, +10%; Bedrock zonder EU-profiel; Foundry alleen "Hosted on Anthropic" |
Azure Data Zone EU, in negen Europese regio’s; prijs niet uitleesbaar |
| Dataretentie | 30 dagen verplicht; zero data retention alleen met uitdrukkelijke toestemming van Anthropic | niet onderzocht voor deze vergelijking |
Bronnen: Anthropic over dataresidentie en Google Cloud, OpenAI over data residency, Microsoft over regio’s; peildatum 22 november 2026.
Bij OpenAI kies je de regio per project, en die kun je achteraf niet wijzigen. Standard, Batch en Fast werken in de EU; Ultrafast alleen in de VS.
Een EU-route is geen vrijbrief: een verwerkersovereenkomst en je eigen afspraken over wat het model mag zien, blijven nodig. De routes per cloud met hun toeslagen staan in AI-modellen in de EU hosten, de contractkant bij de verwerkersovereenkomst van Claude.
Bouw je erop: wat je vooraf vastlegt
Wie beide modellen in eigen software gebruikt, loopt tegen een paar verschillen aan die je liever vooraf weet.
Wissel niet halverwege een gesprek. Alleen Fable 5.2 en Mythos 5.2 lezen de thinking blocks van Fable 5.2 (migratienotities). Schakel je midden in een taak naar een ander model, ook naar Opus 5.5 of Fable 5.1, dan is die redenering weg.
Onze router kiest daarom per taak of per gesprek, nooit per bericht.
Laat een agent melden wat ontbrak. OpenAI schrijft dat beide 6.2-modellen in twee tests vaker obstakels onvermeld lieten, zoals een ontbrekend bestand. In koppelingen zetten wij in de instructie dat de agent expliciet rapporteert wat hij niet kon vinden.
Let op de limieten van Fable. Op de Start-tier van de Claude API mag Fable 5.2 100.000 outputtokens per minuut gebruiken, tegen 400.000 voor Opus 5.5 (rate limits). Fable heeft een eigen pool.
Voor bulkwerk is dat nog een reden om het bij Sol of Opus te leggen.
Controleer de parameters. Fable 5.2 kent geen geforceerde tool_choice en geen temperature; de oude computer-use-tool computer_20251124 geeft buiten Bedrock een 400. GPT-6.2 Sol weigert effort none en doet tool calling alleen via de Responses API.
Hoe wij dit in software vastleggen, met model en effort als instelling in plaats van als code, zie je bij maatwerk software.
Wanneer Fable 5.2 de 26 keer hogere prijs per taak waard is
Onze beslisregel, na alles hierboven:
- Ja, als één gemiste fout meer kost dan een maand modelkosten, als de taak veel stappen zonder mens ertussen heeft, of als een lang dossier in zijn geheel begrepen moet worden.
- Nee, als het om volume gaat, als snelheid voor een klant telt, of als je de uitkomst toch nakijkt.
- Twijfel, dan eerst Opus 5.5 op high.
De test die we daarvoor draaien is eenvoudig. Twintig echte voorbeelden uit je eigen werk, op beide modellen, op een vaste effort-stand.
Tel de fouten, reken de kosten per taak, en kies dan. Het gaat vrijwel nooit om alles of niets: meestal krijgen één of twee taken Fable en draait de rest op Sol of een Claude-middenmodel.
Die modelkeuze per taak is precies wat we in een AI-adviestraject uitzoeken. Stuur ons de taken die je met AI wilt doen en een schatting van het volume; we rekenen ze voor beide modellen door.
Neem contact op of bel 085 016 0118.
Welke versies er verder bestaan, staat op alle Claude-versies en ChatGPT en de OpenAI-modellen.
Opgesteld met AI-ondersteuning, geredigeerd en inhoudelijk verantwoord door Bram Dokman.