Kort antwoord
AI kan met je boekhouding werken zonder dat de AI-verwerking de EER verlaat, maar dan moet elke schakel kloppen en niet alleen het model: voor Claude Opus 5.5, Sonnet 5.5, Sonnet 5 en Haiku 4.5 rekenen per 6 oktober 2026 Amazon Bedrock met een EU-profiel dat je vanuit Frankfurt aanroept en Google Cloud met het eu-endpoint binnen de EER, terwijl Microsoft Foundry en de eigen API van Anthropic dat niet doen; voor GPT rekent de EU Data Zone van Azure met een resource in een EU-lidstaat binnen de EU. Geef het model daarnaast alleen de velden die de vraag nodig heeft, met klantnamen vervangen door codes. Gebruik een Yuki-sleutel met alleen lees-webservices, log elke aanroep en laat geen boeking door zonder akkoord van een mens. Een EU-route regelt waar het model rekent, niet je hele AVG: de verwerkersovereenkomst en de afweging of je een DPIA nodig hebt, blijven gewoon nodig.
Van lezen naar doen.
Yuki draait in Europa. Het AI-model dat je eraan koppelt, hoeft dat niet te doen.
Nmbrs, sinds 1 september 2026 de naam waaronder Yuki verdergaat als Nmbrs Accounting, schrijft bij de AI-koppeling van zijn salarispakket: wat je met een externe AI-tool hebt gedeeld, valt na het loskoppelen "onder het privacybeleid van die tool" (Nmbrs). De Europese belofte van je pakket stopt bij het model dat je eraan hangt.
Daarom is "is deze AI AVG-proof?" de verkeerde vraag. AVG-proof is geen eigenschap van een model; het hangt af van de ingang waarlangs je het aanroept, wat je meestuurt, wie de sleutel heeft en wat er in de logs belandt.
Hieronder volgen we één AI-vraag op een Yuki-administratie, van de API-sleutel tot het logbestand. Per schakel staat waar de data is, wie verwerker is en hoe je dat aantoont; voor de overige vragen over modellen, abonnementen en EU-routes is er de kennisbank AI-modellen vergelijken.
Waar gegevens echt op straat komen
Het lek zit zelden in het model. Het zit in een medewerker met een export, een sleutel met te veel rechten of een log waar niemand aan dacht.
De Autoriteit Persoonsgegevens schreef in 2024: voert een medewerker tegen de afspraken in persoonsgegevens in een AI-chatbot in, dan is dat een datalek (AP, augustus 2024). Hoort het gebruik wel bij het beleid, dan is het geen datalek, maar volgens de AP vaak nog steeds niet toegestaan.
Eind 2025 meldde de AP dat ze in 2024 en 2025 al tientallen meldingen van datalekken via AI-chatbots kreeg, in 2025 meer dan het jaar ervoor, met het meeste risico bij gratis versies (Accountant.nl op basis van het FD, december 2025). Bij de gemeente Eindhoven zetten medewerkers in het najaar van 2025 bestanden met persoonsgegevens in openbare AI-chatbots, waarna de gemeente publieke AI-websites blokkeerde (Binnenlands Bestuur).
Geen van die lekken ging over het datacenter van het model. Ze gingen over wat er naar binnen ging, en via welke ingang.
Een koppeling kan dat afdwingen; een chatvenster niet.
Plakken medewerkers zelf in een chatbot, dan is dat een kwestie van AI-beleid voor medewerkers. Deze pagina gaat over software die automatisch data uit je administratie doorzet.
De datastroomkaart: acht schakels van Yuki tot logbestand
Dit is onze eigen kaart van één AI-vraag op een Yuki-administratie, bijvoorbeeld: "welke debiteuren staan langer dan twee maanden open, en wat is het saldo per relatie?". Per schakel: welke data, waar het staat of rekent, wie verwerker is, wat je instelt en hoe je het achteraf laat zien.
| Schakel | Welke data | Waar | Verwerker | Wat je instelt | Hoe je het aantoont |
|---|---|---|---|---|---|
| 1. Administratie in Yuki | De volledige boekhouding | AWS in Europa, eigen domein en database per klant | Yuki/Nmbrs; een deel van de partijen op Visma's lijst zit buiten de EER, met adequaatheidsbesluit | Niets: dit is de bron | Trust Centre van Visma; het ISAE 3402 Type II-rapport van Yuki |
| 2. API-sleutel | Toegang tot de webservices | In een secrets manager bij de koppeling, nooit in een prompt | Wie de koppeling host | Alleen de lees-webservice AccountingInfo, één sleutel per administratie | Sleutelinstellingen in Yuki (rol Directie of Backoffice) |
| 3. Koppeling of gateway | De opgevraagde records | Een EU-regio, per project vastgelegd | De bouwer of host: wij of jijzelf | Allowlist van methoden; ProcessJournal staat er niet op |
Code, configuratie en verwerkersovereenkomst |
| 4. Filter en pseudonimisering | Alleen de velden die de vraag nodig heeft | In de gateway | Idem | Veldtabel verderop; namen worden codes | De vertaaltabel blijft in de gateway |
| 5. Modelroute | Prompt plus geminimaliseerde data | Bedrock-EU vanuit Frankfurt, of Google eu | AWS of Google | eu.-profiel met een EU-bronregio, of het eu-endpoint |
GetInferenceProfile, CloudTrail, hostnaam van het endpoint |
| 6. Antwoord en actie | Een analyse of een boekingsvoorstel | Van de gateway naar de gebruiker | Bouwer of host | Geen schrijfactie zonder akkoord; aparte schrijfsleutel | Goedkeuringslog |
| 7. Logs | Metadata en een hash van de prompt, geen financiële data | Gateway en cloudlog in de EU | Bouwer of host, en de cloud | Bewaartermijn afgesproken met de klant | Logbeleid in de verwerkersovereenkomst |
| 8. Back-ups en supporttoegang | Wat de koppeling zelf bewaart | Per project vastgelegd | Bouwer of host | Wie erbij mag, en hoe lang | Toegangslijst |
Bronnen voor schakel 1: Nmbrs security, Yuki-support over toegang en databeveiliging en het Visma Trust Centre voor Yuki. Dat ISAE-rapport is van Yuki, niet van ons.
Schakel 5 krijgt in bijna elk gesprek over AI en de AVG de meeste aandacht. De lastigste vragen zitten in schakel 2, 4 en 7: wie heeft de sleutel, wat gaat er mee, en waar staat de kopie waar niemand aan dacht.
Ook schakel 1 ligt niet volledig in de EER: Visma vermeldt bij Yuki ook Sentry, Datadog en Appcues (VS) en Orca Security (Israël), met als locatie een land met een adequaatheidsbesluit. Dat is geen verwijt aan Yuki; het laat zien dat "binnen de EER" per schakel een aparte vraag is.
Welke route verwerkt binnen de EU? Claude en ChatGPT naast elkaar
Hetzelfde model kun je via verschillende ingangen aanroepen. Elke ingang geeft een ander antwoord op twee vragen: waar rekent het, en wie is je verwerker?
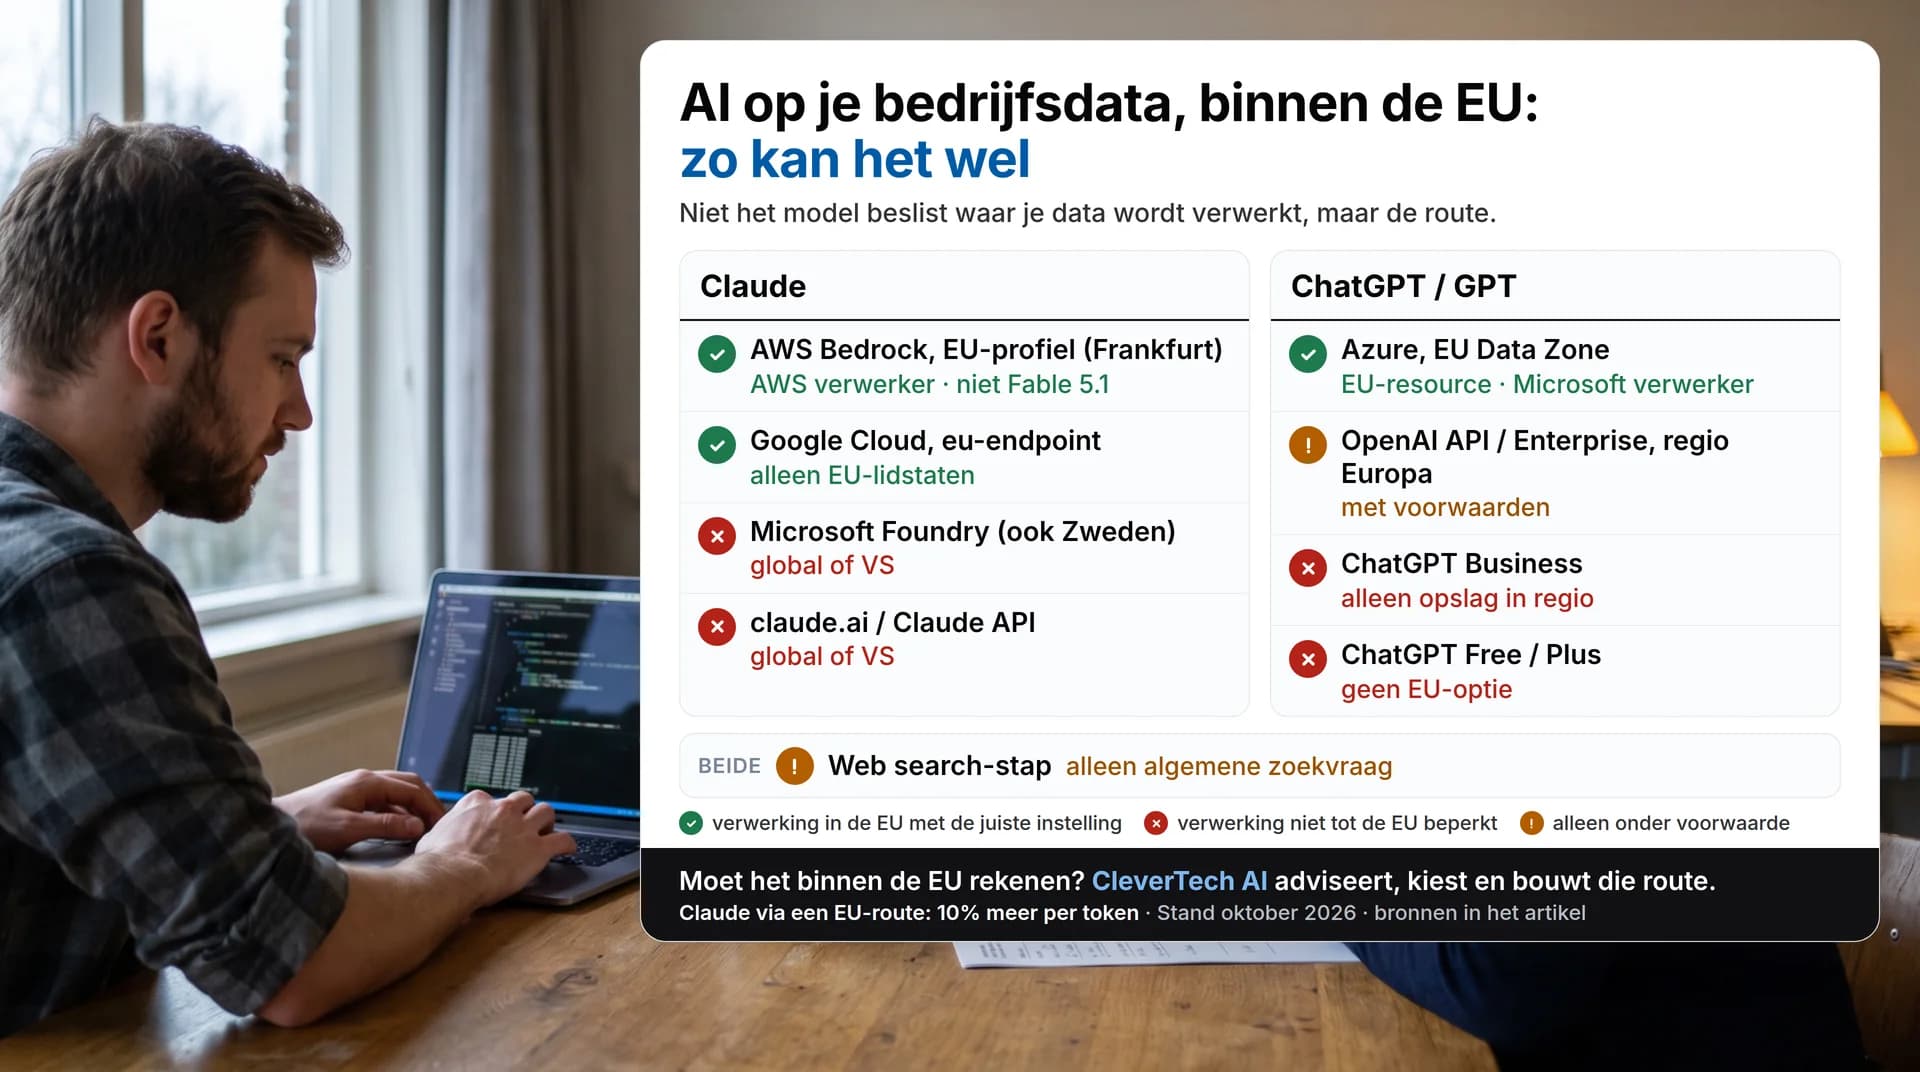
Dit overzicht is onze samenvatting van de documentatie van Microsoft, AWS, Google, Anthropic en OpenAI, gelezen op 6 oktober 2026; de ChatGPT-plannen Enterprise, Business en Free lazen we op 18 september 2026 in het Help Center van OpenAI. ✓ betekent verwerking in de EU met de juiste instelling, ✗ verwerking die niet tot de EU beperkt is, ! alleen onder voorwaarde.
Claude
| Route | Verwerking beperkt tot de EU? | Voorwaarde of kanttekening | Verwerker |
|---|---|---|---|
Amazon Bedrock, eu.-profiel, aangeroepen vanuit Frankfurt |
✓ Ja, in zes regio's in EU-lidstaten | Voor Opus 5.5, Sonnet 5.5, Sonnet 5 en Haiku 4.5; Fable 5.1 heeft geen EU-profiel | AWS; Anthropic heeft geen toegang tot prompts, antwoorden of Bedrock-logs |
Hetzelfde eu.-profiel, aangeroepen vanuit Londen of Zürich |
✗ Nee | Londen of Zürich hoort dan bij de bestemmingen | AWS |
| Google Cloud, eu-endpoint | ✓ Ja, alleen EU-lidstaten | Het VK en Zwitserland vallen erbuiten; hier staat ook Fable 5.1 | |
| Microsoft Foundry, ook met een resource in Sweden Central | ✗ Nee | Bij Hosted on Azure opslag in rust in Zweden, maar verwerking via Global Standard (elke Azure-regio) of de Amerikaanse Data Zone; niet af te nemen op een CSP-abonnement | Anthropic, als zelfstandige verwerker |
| Claude API van Anthropic | ✗ Nee | Alleen global of us |
Anthropic |
| claude.ai, van Free tot en met Enterprise | ✗ Nee | Geen EU-optie; Free, Pro en Max hebben geen verwerkersovereenkomst | Anthropic; bij Free, Pro en Max niet als verwerker van je bedrijf |
| Claude in Microsoft 365 Copilot | ✗ Nee | Buiten de EU Data Boundary; staat voor EU-klanten standaard uit | Microsoft, met Anthropic als subverwerker (bij "Anthropic models with Data Retention" is Anthropic zelfstandig verwerker) |
ChatGPT / GPT
| Route | Verwerking beperkt tot de EU? | Voorwaarde of kanttekening | Verwerker |
|---|---|---|---|
| Microsoft Azure (Foundry of Azure OpenAI), Data Zone Standard EU | ✓ Ja, met een resource in een EU-lidstaat: dan verwerkt Microsoft "in that or any other European Union Member Nation" | Onder meer GPT-6.1 Sol, GPT-6 Sol, GPT-6 Luna en de GPT-5.6-familie; de EU Data Zone als geheel kan ook EFTA-regio's zoals Zwitserland omvatten | Microsoft; OpenAI krijgt prompts en antwoorden niet |
OpenAI API, regio Europa (eu.api.openai.com) |
! Onder voorwaarde | Opslag en verwerking in Europa (EER plus Zwitserland), alleen na goedkeuring door OpenAI, met een retentie-amendement en alleen voor nieuwe projecten | OpenAI |
| ChatGPT Enterprise of Edu met data- en inferentieresidentie Europa | ! Onder voorwaarde | Alleen nieuwe werkruimtes, via sales; GPT's van derden en Codex Web vallen erbuiten | OpenAI |
| ChatGPT Business | ✗ Nee, alleen de opslag | De regio bepaalt de opslag in rust; een kopie van elke prompt en elk antwoord staat tijdelijk in de VS, en verwerking in de regio zit er niet bij | OpenAI |
| ChatGPT Free, Go, Plus of Pro | ✗ Nee | Geen residentie en geen verwerkersovereenkomst | OpenAI, maar niet als verwerker van je bedrijf |
Voor beide, de web search-stap (!): bij geen enkele aanbieder is de zoekstap aantoonbaar binnen de EU-route, en Microsoft zegt letterlijk dat de data dan buiten de compliancegrens gaat.
Die stap krijgt dus alleen een algemene zoekvraag. Hoe we dat bouwen, staat verderop bij de gesplitste opzet.
De routes met een ✗ staan er bewust in. Juist daar gaat het in de praktijk mis.
Microsoft Foundry: wel Claude, geen Europese datazone
Microsoft biedt Claude in Foundry in twee deploymenttypes aan: Global Standard en Data Zone Standard, en die datazone is de VS (Microsoft Learn, 21 september 2026). Anthropic schrijft er letterlijk bij dat de datazone "inference within the United States" houdt.
Bij Global Standard mag Microsoft de verwerking volgens de eigen documentatie in elke Azure-regio laten plaatsvinden (Microsoft Learn, deployment types).
Ook een resource in Sweden Central verandert dat niet. Volgens Microsoft staat de data in rust dan in de gekozen Azure-geografie, dus in Zweden, maar de verwerking volgt nog steeds Global Standard of de Amerikaanse datazone.
Dan de verwerkersvraag. Volgens Microsoft is Anthropic in Foundry bij beide hostingopties de verkoper, de operator en een zelfstandige verwerker van prompts en antwoorden, en is Claude een "Non-Microsoft Product".
Daardoor gelden de voorwaarden en de verwerkersovereenkomst van Anthropic, niet de EU Data Boundary van Microsoft. Kies je "Hosted on Azure", dan lopen prompts en antwoorden over Azure-infrastructuur, maar binnen Azure is iets anders dan binnen de EER: de verwerking volgt nog steeds Global of de Amerikaanse datazone.
Gebruiksmetadata en content die de veiligheidssystemen markeren, gaan volgens Anthropic wel naar Anthropic (Anthropic, Claude in Microsoft Foundry).
Medewerkers van Anthropic bekijken die content volgens Microsoft "on an exceptions-only basis". Europa staat voor Foundry op de compliancepagina van Anthropic als "Coming soon", zonder datum (Anthropic, regional compliance).
Dan het punt dat ons zelf raakt. Wij verkopen Microsoft-licenties als reseller via Pax8, en volgens Microsoft is Claude in Foundry niet af te nemen op een abonnement via een Cloud Solution Provider: precies de manier waarop wij Microsoft leveren. Voor Claude met een EER-eis adviseren we nu dus een andere cloud.
Wat de EU Data Boundary voor Copilot wél regelt, staat op Microsoft 365 Copilot en de AVG. Claude binnen Microsoft 365 Copilot valt volgens Microsoft buiten die grens en staat voor klanten binnen de EU Data Boundary standaard uit (Microsoft Learn, 18 september 2026).
Amazon Bedrock: ja, als je vanuit een EU-lidstaat aanroept
Op Bedrock hebben Claude Opus 5.5, Sonnet 5.5, Sonnet 5 en Haiku 4.5 per 6 oktober 2026 een EU-inferentieprofiel (AWS-modelkaart Sonnet 5.5). Sonnet 5.5 kreeg dat profiel na de lancering: bij onze controle op 29 september stond het er nog niet.
Roep je het profiel aan vanuit Frankfurt (eu-central-1), dan stuurt AWS het verzoek naar zes regio's in EU-lidstaten: Frankfurt, Stockholm, Milaan, Spanje, Ierland en Parijs. Roep je hetzelfde profiel aan vanuit Londen of Zürich, dan komt die stad bij de bestemmingen, en die ligt buiten de EER.
Het voorvoegsel eu. is dus pas een EER-route met een bronregio in een EU-lidstaat. AWS raadt zelf aan om niet op het voorvoegsel te vertrouwen, maar per bronregio de bestemmingen op te vragen met GetInferenceProfile (AWS, inference profiles).
CloudTrail logt elk cross-region-verzoek in je bronregio (AWS, cross-region inference). Daarmee laat je achteraf zien waar een aanroep draaide.
Op Bedrock is AWS de verwerker. Modelaanbieders hebben volgens AWS geen toegang tot prompts, antwoorden of Bedrock-logs (AWS, data protection), en AWS en de modelaanbieders trainen niet op wat je via Bedrock stuurt (AWS Bedrock FAQ).
Bedrock bewaart standaard geen input en output.
Voor Claude is Fable de uitzondering: bij Claude Fable 5 en 5.1 bewaart AWS al het verkeer "for up to 30 days" voor misbruikdetectie, door AWS zelf en zonder het met de modelaanbieder te delen; klanten in het Enterprise Frontier Safeguards-programma krijgen tot 31 december 2026 nog zero data retention (AWS, abuse detection). Fable 5.1 heeft op Bedrock bovendien geen EU-profiel.
Google Cloud: ja, met het eu-endpoint
Google trekt de grens scherper: het eu-endpoint dekt alleen EU-lidstaten, en het VK en Zwitserland vallen er expliciet buiten (Google Cloud, data residency, 6 oktober 2026). De ML-verwerking blijft dan volgens Google binnen de EU; het globale endpoint geeft geen residency-garantie.
Op het eu-endpoint staan per 6 oktober 2026 onder meer Opus 5.5, Sonnet 5.5, Sonnet 5, Haiku 4.5 en Fable 5.1. Het kost 10% meer dan het globale endpoint (Anthropic, Claude on Vertex AI), en Google is de verwerker.
Wat je per cloud precies instelt en wat het kost, staat op Azure OpenAI of Claude via Bedrock en Vertex. Welke modelfamilie überhaupt een Europese route heeft, lees je op AI-modellen in de EU laten draaien.
GPT via Microsoft Azure, en OpenAI zelf
Voor modellen die Azure zelf verkoopt, zoals GPT, is Microsoft wel de verwerker. Met Data Zone Standard EU en een resource in een EU-lidstaat, zoals Sweden Central, verwerkt Microsoft prompts en antwoorden "in that or any other European Union Member Nation", en krijgt OpenAI ze niet (Microsoft Learn, data privacy).
Staat de resource in een EFTA-regio zoals Zwitserland, dan geldt die beperking niet: de EU Data Zone als geheel kan ook Zwitserland omvatten, en dat ligt buiten de EER (Microsoft Learn, deployment types).
Wie OpenAI rechtstreeks afneemt, heeft Europa (EER plus Zwitserland) alleen onder voorwaarden: op de API na goedkeuring door OpenAI en voor nieuwe projecten (OpenAI, Your data), op ChatGPT Enterprise en Edu voor nieuwe werkruimtes. ChatGPT Business regelt alleen de opslag in rust.
Welke GPT-modellen in de EU-zone staan, staat bij Azure OpenAI of Claude via Bedrock en Vertex; de details per ChatGPT-plan bij de verwerkersovereenkomst van ChatGPT.
Claude of GPT: welke route past wanneer
Voor dit gebruik, AI op gevoelige bedrijfsdata, verschillen ze vooral in de route:
- Zit je al op Microsoft en werk je met GPT, dan is de EU Data Zone van Azure de voor de hand liggende route, met Microsoft als verwerker.
- Wil je Claude op gevoelige data, dan loopt dat nu via Bedrock met een EU-profiel vanuit Frankfurt, of via Google Cloud met het eu-endpoint.
- De grens verschilt: Google eu is strikt EU-lidstaten, Bedrock vanuit Frankfurt zes regio's in EU-lidstaten, Azure met een resource in een EU-lidstaat ook, en de regio Europa van OpenAI omvat Zwitserland.
Welk model inhoudelijk beter bij je werk past, is een andere vraag; die staat bij Claude of ChatGPT zakelijk.
Wat kost verwerking binnen de EU?
Voor Claude kost een EU-route 10% meer per token dan de globale route. Anthropic noemt die toeslag voor de regionale en multi-regio-endpoints op Google Cloud (Anthropic, Claude on Vertex AI).
Op Bedrock heet het EU-profiel bij AWS "standard pricing" en is het globale profiel circa 10% goedkoper; de prijslijst laat hetzelfde verschil zien (AWS, Bedrock pricing).
Een rekenvoorbeeld met Sonnet 5.5 op Bedrock in Frankfurt: globaal $2 per miljoen tokens in en $10 uit, met het EU-profiel $2,20 en $11.
| Vraag van 10.000 tokens in en 1.000 uit | Invoer | Uitvoer | Totaal per vraag |
|---|---|---|---|
| Global | $0,020 | $0,010 | $0,030 |
| EU-profiel | $0,022 | $0,011 | $0,033 |
Dat is drie tiende cent per vraag, of $30 extra per 10.000 vragen.
Een vaste 10% is het niet overal: GPT-6 Sol kost via de EU Data Zone van Azure 20% meer (Azure-prijslijst, 6 oktober 2026). De toeslagen per cloud en model staan bij AI-modellen in de EU laten draaien.
Actuele informatie opzoeken zonder je bedrijfsdata mee te sturen
Soms heeft een vraag op je boekhouding actuele informatie nodig: een btw-tarief, een nieuwe regeling, een rentestand. Dan moet de AI zoeken, en die zoekstap is bij geen enkele aanbieder aantoonbaar binnen de EU-route.
- Op Bedrock zit web search er niet in. Anthropic noemt web search, web fetch en code execution bij de functies die Bedrock niet ondersteunt (Anthropic, Claude in Amazon Bedrock).
- De web search-tool van Anthropic draait op de Claude API, Claude Platform on AWS en Foundry, en in een basisversie op Google Cloud (Anthropic, web search tool). De eerste drie hebben geen EU-route; waar de zoekstap op Google Cloud draait, documenteert Anthropic niet.
- Bij Microsoft staat het er letterlijk: met Grounding with Bing Search "your data flows outside the Azure compliance and Geo boundary", en de verwerkersovereenkomst van Microsoft geldt daar niet (Microsoft Learn, web search tools).
Naar Bing gaan volgens Microsoft alleen de zoekvraag, de toolparameters en je resourcesleutel (Microsoft Learn, Bing tools). Maar die zoekvraag maakt het model zelf uit de vraag van de gebruiker, en daar kan zonder rem een klantnaam of bedrag in belanden.
Daarom bouwen we het gesplitst:
- De vraag op je bedrijfsdata loopt via Claude op Bedrock met een EU-profiel vanuit Frankfurt, of via het eu-endpoint van Google, zonder web search.
- Actuele informatie komt uit een aparte aanroep die alleen een algemene zoekvraag krijgt, zoals "btw-tarief 2026 kinderopvang", zonder namen, bedragen of relatiecodes. De gateway stelt die zoekvraag op uit vaste sjablonen of een allowlist, zodat het model geen bedrijfsdata kan meegeven.
- Het zoekresultaat gaat terug naar de EU-route, waar het model het combineert met je cijfers.
Ook een algemene zoekvraag is een gegevensstroom; leg dus vast wat erin mag. Pseudonimiseren verkleint het risico, maar maakt de data niet anoniem, zoals hieronder bij de veldtabel staat.
Wat het model van je boekhouding te zien krijgt
De regio is de helft van het verhaal. De andere helft is wat je meestuurt.
Dit is onze veldtabel voor boekhouddata. Het is een werkwijze, geen wettelijke lijst.
| Gaat nooit naar het model | Wordt vervangen door een code | Mag mee als de vraag het nodig heeft |
|---|---|---|
| IBAN | Relatienaam (wordt REL-0042) | Bedragen en datums |
| BSN, bij eenmanszaken | Naam van een eenmanszaak | Grootboekrekening en RGS-code |
| Adres, e-mail en telefoon | Contactpersoon | Btw-code en boekingsperiode |
| Vrije omschrijvingen met namen | Openstaand saldo per relatiecode | |
| Bonnen en facturen als bestand |
Ook alleen-lezen levert documenten op. Via AccountingInfo en het archief haal je facturen en bonnen op, met namen, adressen en IBAN's erop; bij ons gaat een document alleen mee als de taak het echt vraagt, en dan alleen het relevante deel.
De vertaaltabel van code naar naam blijft in de gateway. Het model ziet REL-0042, de gebruiker krijgt de naam terug in het antwoord.
Dat verkleint het risico, maar maakt de data niet anoniem. Volgens de EDPB blijven gepseudonimiseerde gegevens persoonsgegevens zolang ze met aanvullende informatie te herleiden zijn (EDPB-richtsnoeren 01/2025), en die informatie heb je zelf.
Waarom dan niet volledig anonimiseren? Omdat een boekhoudvraag meestal over een bepaalde relatie gaat.
Een code die je terug kunt vertalen is de werkbare middenweg; echte anonimisering maakt het antwoord onbruikbaar.
Het principe erachter, pseudonimiseren in de software en niet in een werkinstructie, staat bij AI en de AVG per model.
Sleutels en rechten in Yuki: alleen lezen is geen schakelaar
Alleen gebruikers met de rol Directie of een Backoffice-rol kunnen webservices instellen. Yuki schrijft erbij: "Omdat webservices toegang geven tot de kern van je administratie, is de inrichting hiervan streng beveiligd" (Yuki-support, webservices instellen).
Bij veel ondernemers is het accountantskantoor eigenaar van het domein, en dus degene die de sleutel aanmaakt. Hoe de API werkt en hoe dat eigenaarschap zit, staat op Yuki koppelen via je accountant.
Een knop "alleen lezen" heeft een Yuki-sleutel niet. Je kiest per sleutel welke van de 12 webservices hij mag gebruiken, en Yuki adviseert zelf om alleen te selecteren wat je nodig hebt. Daar zit de echte instelling:
- AccountingInfo heeft alleen opvraag- en sessiemethoden, geen methode die boekingen of relaties wijzigt (AccountingInfo-webservice).
- Accounting combineert lezen (saldi, openstaande posten) met memoriaalboekingen via
ProcessJournal. - Neem je Accounting op, dan moet de koppeling zelf de schrijfmethoden blokkeren.
- Vertrouw je een sleutel niet meer, genereer dan een nieuwe: dat is Yuki's eigen advies.
Standaard krijgt een domein 1.000 webservice-calls per dag, uit te breiden naar 5.000 of 10.000 (Yuki-support, API-koppeling). Voor een AI-laag is dat een nuttige rem: een model dat in een lus blijft vragen, loopt tegen een plafond aan.
Nmbrs past bij zijn eigen AI-assistent in het salarispakket hetzelfde principe toe: die voert geen mutaties zelfstandig door, de gebruiker keurt eerst goed (Nmbrs, AI-veiligheid). Dat gaat over Nmbrs Payroll, niet over het boekhoudpakket, maar het is het patroon dat wij ook bouwen.
Wie bij een agent op je boekhouding welke goedkeuring geeft, staat uitgewerkt bij human in the loop voor AI-agents.
Wie is verwerker van wie
Bij een AI-laag op een boekhoudpakket lopen vier of vijf partijen door elkaar. Leg vooraf vast wie welke rol heeft:
- De ondernemer en het kantoor: leg vast wie verwerkingsverantwoordelijke is; dat kan de ondernemer zijn, het kantoor, of allebei voor hun eigen doelen.
- Het accountantskantoor: vaak eigenaar van het Yuki-domein en degene die sleutels aanmaakt.
- Yuki/Nmbrs: verwerker van de administratie zelf.
- De bouwer of host van de koppeling: verwerker zodra die persoonsgegevens doorgeeft of bewaart.
- De cloud- of modelaanbieder: AWS of Google op hun eigen platform, Anthropic bij Foundry en de eigen API.
Artikel 28 van de AVG vraagt dat je alleen werkt met verwerkers die "afdoende garanties" bieden en dat je de verwerking vastlegt in een overeenkomst (AVG, EUR-Lex). Een verwerker schakelt geen subverwerker in zonder schriftelijke toestemming, en jij moet bezwaar kunnen maken.
Voor een AI-koppeling komt dat neer op een verwerkersovereenkomst met de bouwer. Draait het in ons cloudaccount, dan is de cloudleverancier onze subverwerker; draait het in jouw account, dan is hij rechtstreeks jouw verwerker onder zijn eigen verwerkersovereenkomst.
Verwerken wij persoonsgegevens namens je, dan leggen we dat vast in een verwerkersovereenkomst conform artikel 28 AVG (artikel 7 van onze voorwaarden).
Loopt de route via Anthropic zelf, dan gebruikt de DPA van Anthropic Standard Contractual Clauses als grondslag voor de doorgifte naar de VS (artikel 46 AVG); of die doorgifte voor jouw verwerking volstaat, toets je zelf. Je hebt dan 15 dagen om bezwaar te maken tegen een nieuwe subverwerker, Anthropic meldt een beveiligingslek uiterlijk binnen 48 uur en verwijdert klantdata binnen 30 dagen na het contract (Anthropic DPA).
Hoe dat per Claude-plan uitpakt, staat bij de verwerkersovereenkomst van Claude.
Een DPIA is niet automatisch verplicht als AI persoonsgegevens leest, maar je moet het wel beoordelen en vastleggen. De AP hanteert als vuistregel twee of meer criteria uit haar lijst, en vraagt ook bij nul of één criterium een onderbouwing waarom je geen DPIA doet (AP over de DPIA).
Voor accountantskantoren speelt naast de AVG ook de beroepsplicht tot vertrouwelijkheid (VGBA artikel 2). Volgens de NBA/NOREA-leidraad "AI toegepast" (juni 2026) mag AI nooit een "black box" zijn (NBA).
Wij zijn een IT-bureau, geen advocatenkantoor. Hierboven staat wat de bronnen zeggen; het oordeel voor jouw verwerking hoort bij je jurist of privacyadviseur.
Wat een EU-route niet oplost
Jurisdictie. De Amerikaanse CLOUD Act kan Amerikaanse aanbieders verplichten data te verstrekken, ongeacht waar die staat. Microsoft Frankrijk zei op 10 juni 2025 onder ede in de Franse Senaat niet te kunnen garanderen dat gegevens nooit op bevel van de Amerikaanse overheid worden overgedragen ("Non, je ne peux pas le garantir"), en ook dat het nog nooit is gebeurd (Sénat).
Dat geldt voor elke Amerikaanse aanbieder, ook voor AWS en Google. Een EU-route regelt de locatie van de verwerking, niet de jurisdictie van de aanbieder; dat risico weeg je af met dataminimalisatie, versleuteling en een transfer impact assessment, zie digitale soevereiniteit en Europese AI.
Bewaartermijnen per model. Voor de Fable- en Mythos-modellen spreekt Anthropic van "at least 30 days" bewaring, ook op Bedrock, Google en Foundry (Anthropic, Covered Models); AWS noemt voor Bedrock "up to 30 days", met zero data retention tot 31 december 2026 voor klanten in het Enterprise Frontier Safeguards-programma. Voor de andere modellen verwijdert Anthropic input en output op de eigen API binnen 30 dagen; zero data retention is per organisatie aan te vragen, maar ook dan mag gemarkeerde content tot 2 jaar bewaard worden.
Trainen is weer een andere vraag dan bewaren. Welke aanbieder standaard op je data traint en hoe je dat uitzet, staat bij AI-training op je data uitzetten.
De bewaarplicht. De fiscale bewaarplicht van 7 jaar, en 10 jaar voor gegevens over onroerende zaken, blijft bij je administratie in Yuki (Belastingdienst). Een AI-laag is geen archief, en hoort ook geen tweede kopie van je boekhouding op te bouwen.
De AI Act. Een boekhoud-assistent is doorgaans geen hoog-risicosysteem; de hoog-risicoregels gaan in op 2 december 2027 en 2 augustus 2028 (Verordening 2026/1744). Voor de meeste mkb-toepassingen gaat het om transparantie en AI-geletterdheid.
Zo bouwen wij AI op Yuki
Dit is onze referentie-architectuur. Een opgeleverd project waarin AI uit Yuki leest, hebben we nog niet; wat hieronder staat, is hoe wij het bouwen, op basis van koppelingen en maatregelen die we wel al gebouwd hebben.
- Een eigen sleutel met de kleinste scope. Per administratie een aparte sleutel, aangemaakt door Directie of Backoffice, met alleen AccountingInfo; zijn openstaande posten nodig, dan Accounting erbij met een allowlist van leesmethoden.
ProcessJournalgaat er nooit door, en de sleutel staat in een secrets manager, nooit in een prompt of in code. - Een gateway tussen Yuki en het model. Alleen de koppeling heeft de sleutel; het model vraagt gegevens op via tools met een vast schema. De gateway draait in een EU-regio, in het cloudaccount van de klant of in een omgeving die we per project vastleggen.
- Dataminimalisatie vóór het model. Alleen de velden uit de veldtabel die de vraag nodig heeft; documenten alleen als de taak dat vraagt.
- Pseudonimisering. Relatienamen worden codes, en de vertaaltabel blijft in de gateway.
- Een modelroute met een EER-eis. Claude via Amazon Bedrock met een
eu.-profiel vanuit Frankfurt, of via Google Cloud met het eu-endpoint; niet via Foundry, de directe API of een global-profiel. Bij de inrichting controleren we de bestemmingen metGetInferenceProfile. Zoeken op internet loopt nooit via deze route, maar als aparte stap met alleen een algemene zoekvraag. - Logging zonder tweede datakluis. Per aanroep: wie, wanneer, welke Yuki-methode, welke administratie, hoeveel records, welk model en welke regio, plus een hash van de prompt. De financiële data zelf loggen we niet, en de bewaartermijn spreken we met de klant af.
- Geen boeking zonder akkoord. De AI stelt voor, een mens keurt goed, en pas daarna voert een aparte schrijfsleutel de actie uit, weer via een allowlist. Schrijftools staan standaard uit tot je ze expliciet vrijgeeft.
- Het papierwerk. Wie is verwerkingsverantwoordelijke, een verwerkersovereenkomst met ons (met de cloudleverancier als onze subverwerker, of als jouw eigen verwerker als het in jouw account draait), en de afweging of een DPIA nodig is. We helpen het vast te leggen; een juridisch oordeel geven we niet.
Eist een klant verwerking in de EU, dan zetten we Claude zo in, via Bedrock of Google Cloud in een EU-regio. Dat is een keuze die we per project vastleggen, geen eigenschap van alles wat we bouwen.
Wat we al bouwden
- Huurdersportaal: een zelfgebouwde Yuki-integratie via SOAP, met een organisatiefilter op alle queries over 24 modellen plus Postgres row-level security. Verder gehashte API-sleutels, SSRF-bescherming op webhooks en een volledig audit-log; twee interne audit-rondes losten 28 en 18 issues op (case).
- Senco Stock: een eigen Yuki-connector die orders, klanten en terugbetalingen omzet in verkoopfacturen, relaties en creditnota's, met vier btw-scenario's en een VIES-controle. Die schrijft naar Yuki, zonder AI (case).
- Een zorgproject in het VK: een kill-switch op de hele koppeling, een dubbele goedkeuring waarbij niemand zijn eigen werk kan goedkeuren, en een hash-geketende audit-log die manipulatie zichtbaar maakt. Dat valt onder de UK GDPR, niet onder de AVG.
Dat zijn interne audits en eigen ontwerpkeuzes, geen externe certificering. Hoe de technische bouw van zo'n koppeling op een boekhoudpakket verloopt, staat uitgeschreven bij Exact Online koppelen aan Claude via MCP; wat MCP wel en niet regelt, bij wat is MCP.
Kies je toch voor de directe API van Anthropic, bijvoorbeeld omdat je geen EER-eis hebt, dan staat de technische kant bij de Claude API koppelen aan eigen software. Een chatwerkruimte voor medewerkers is weer iets anders dan zo'n koppeling; die afweging staat bij ChatGPT Enterprise of private AI.
Wat het kost
Een AI-koppeling die alleen leest, begint bij €5.000; mag de AI ook schrijven, dan kost het €7.500 tot €15.000. Waar dat bedrag uit bestaat, staat op wat een MCP-server kost.
Een gewone Yuki-koppeling zonder AI bouwen we vanaf €5.000 voor één richting, met beheer van €150 tot €500 per maand. Code, documentatie en data zijn van jou: bij oplevering dragen we broncode, documentatie en data over.
Wil je weten welke route en welke velden bij jouw administratie passen, dan lopen we de kaart met je door in een kort gesprek, of bel 085 016 0118 via contact. Laat je het bouwen, dan valt het onder AI-software op maat; wil je eerst je hele AI-inrichting langs de AVG laten lopen, dan is AI-advies de plek.
Opgesteld met AI-ondersteuning, geredigeerd en inhoudelijk verantwoord door Bram Dokman.